腾讯开源 Hy Memory 2.0:换了 AI 工具,任务记忆也能接着用?
在一个 AI 工具里交代过项目背景,换到另一个工具却又要从头解释;昨天已经否决的方案,今天重新开会话又被推荐回来。对于长期使用智能体的人,这类重复沟通常常比一次回答慢几秒更烦。
10 月 16 日,腾讯混元发布 Hy Memory 2.0,并同时开放专用模型、记忆框架与 MemHub 应用。IT之家当天报道记录了这次三层开放的发布节点。它尝试解决的是:任务跨会话、跨工具之后,哪些信息应该留下,哪些决定已经过期,下次又该取回什么。
三层开放,分别负责什么?
三个名字放在一起容易混淆,可以按工作分工来理解。
**Hy-Memory-30B-A3B 是记忆写入模型。**按照官方模型卡的定义,它在外部记忆框架中判断信息是否值得保留、应如何准确表达,以及新证据应怎样更新已有记录。它并不是给所有 AI 工具统一换上的通用回答模型。
**Hy-Memory 是管理记忆的框架与 SDK。**它负责组织存储、更新和召回,开发者可以接入自己的智能体。模型卡说明,专用写入模型还可以进入 Mem0、MemOS 等其他系统,并不要求所有人使用同一套框架。
**MemHub 是用户接触的应用。**它把明确授权的 AI 对话与编码记录整理到一份本地记忆,再分别授权给支持的工具调用。发布页列出了包括 Cursor、Claude Code、Codex、WorkBuddy 等在内的十种工具;这指发布方列出的集成范围,不等于任意客户端、任意版本都已获得相同程度的验证。
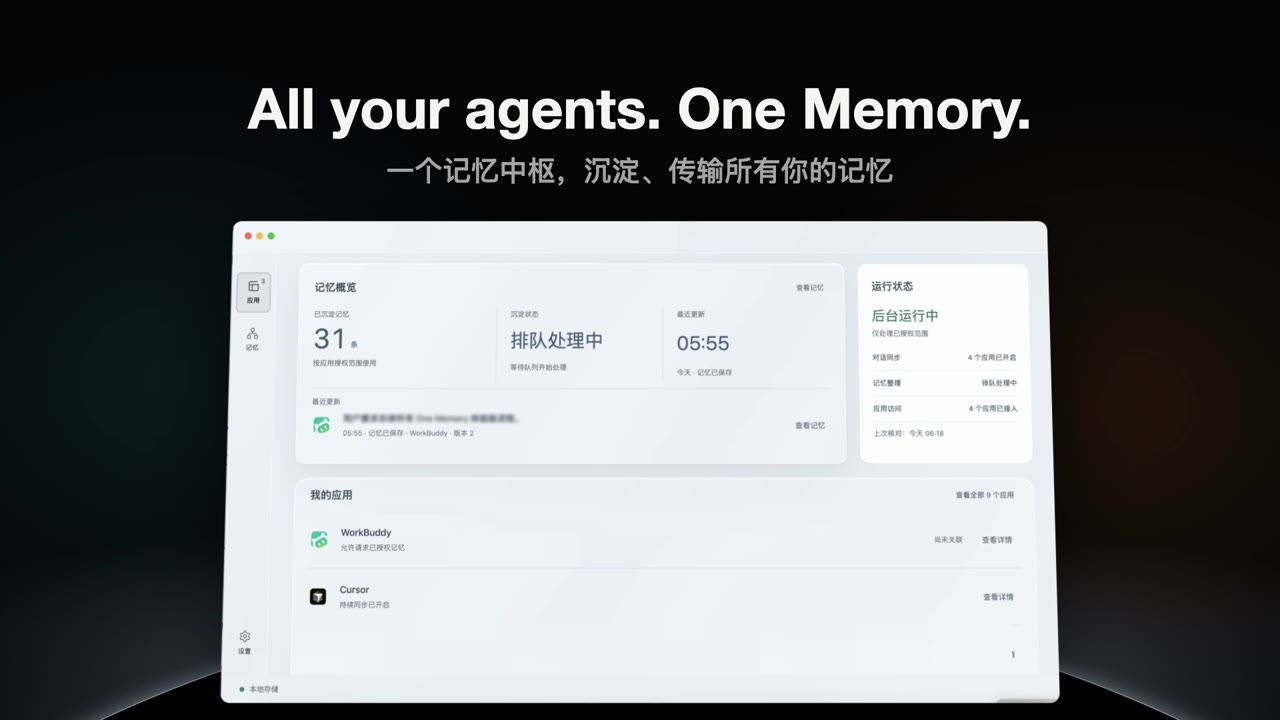
图源:腾讯 Hy Memory 官网的 MemHub 演示预览图,2026 年 10 月 18 日核查。展示的是厂商产品界面示例,并非本站安装后的个人试用截图;画面中的记忆条数也不是实际测试结果。
应用目前仍有明确的成熟度边界。MemHub 仓库说明标注 preview,当前明确不支持 Windows;macOS、Linux 也应按 Release 中实际制品及对应版本说明核对。公开了源码,与每个平台都已提供完善安装体验,需要分开看。
为什么“把所有历史塞回去”还不够?
技术论文把长期记忆系统拆为写入、检索和读取回答三个环节。检索再强,也很难找回从来没有正确保存的内容;反过来,毫无选择地全部保存,又会增加成本与干扰。
举一个假设例子:项目最初决定兼容某个旧接口,后来确认可以移除。只留下“需要兼容旧接口”这一句,后续 AI 可能继续做无用工作;只保留最终结论,又可能解释不了历史代码为什么这样写。有效记忆需要同时处理当前状态、变更过程与适用条件。
这也是 2.0 新增工作记忆和代码记忆的看点。框架文档将工作记忆区分为会话事实与可复用经验:前者记录这次做了什么,后者记录以后什么条件下可以复用。代码场景还加入版本演进链,补足单靠文字摘要容易丢失的修改轨迹。
这类外部记忆与大上下文也不相同。上下文窗口决定模型这一次能处理多少材料;记忆系统决定跨会话保存和取回哪些材料。两者可以配合,但窗口更大并不会自动替用户完成去重、纠错和权限管理。
“超过 Opus 5”是什么范围的结论?
官方公布的模型平均分为 55.49,Claude Opus 5 为 54.62,相差 0.87 分。这是一组记忆写入评测,而不是通用聊天、推理或编程能力总榜。
模型卡与论文把条件交代得比较具体:主矩阵使用固定的 20% 基准子样本,在四套记忆系统上比较六项指标;比较时固定检索配置、回答模型、评判模型等组件,主要更换记忆写入模型。EverMemOS 不参与训练,用于检验跨框架迁移。
更值得保留的是论文自己写出的限制:在 Hy-Memory 和 MemOS 上,相比 Opus 5 的优势只有 0.02、0.01 分,作者明确表示,这些微小差距不能视为统计上已经分出高下。未参与训练的框架上差距更大,但也不能由一个保留框架推断所有系统都同样受益。
另外,发布页的“框架评测”和这里的“写入模型评测”不是同一张成绩单。前者比较整套记忆方案,后者主要检验写入模型;不能把两个部分的最好数字拼成一个新的总体结论。本文没有独立复现这些测试。
本地记忆,不自动等于完全离线
跨工具记忆越方便,数据流向就越需要让用户看得清楚。这是选择这类产品时的实际功能问题。
MemHub 隐私说明区分了来源读取、模型处理和宿主读取三道授权:允许导入某个工具的历史,并不等于允许任意其他工具或模型服务读取全部内容。
文档还明确,用户选择第三方模型服务时,完成任务所需的已授权内容会发送给该服务。因此,“记忆保存在本地”不能直接理解为整个处理过程完全不出网。使用哪家模型、发送哪些内容、用于什么目的,应该在启用前可见。
记忆的生命周期也与程序安装不同。按当前说明,卸载默认保留用户记忆数据,删除数据需要独立确认;更正、撤权和暂停则属于持续管理的一部分。对读者来说,能查看并纠正一条错误记忆,与能自动记住一条信息同样有用。
Hy Memory 2.0 带来的变化,是让长期记忆可以作为独立组件,在不同模型和工具之间组合。它与此前 Meta Muse Wonder 的产品记忆方向可以放在一起观察:今后的竞争不仅是一次回答有多强,也包括几周之后,系统能否正确延续已经确定的工作。
目前模型卡、Hy-Memory 框架和 MemHub 文档均标注 Apache 2.0。开放材料让外部开发者有机会检查和改进这些机制;至于真实项目里能减少多少重复沟通,仍要由实际记录的准确性、召回效果和工具适配来证明。
评论