DeepSeek V4.1 Flash 1017 更新:单价没降,为何任务成本还能更低?
如果你的程序一直在调用 deepseek-flash,这次更新可能已经生效,而配置文件一个字都没改。
DeepSeek 在 10 月 17 日的官方更新日志中确认,V4.1 Flash 已升级为 DeepSeek-V4.1-Flash-1017,网页、App 和 API 同步切换,调用方式与价格保持不变。官方把它称作小版本更新,但公布的变化并不只是一处界面调整:多项编程和智能体任务分数上升,同时声称缩短任务耗时和输出长度。
这里值得追问的是:单价没降,为什么还可能更省钱?以及这些成绩能不能直接代表自己的工作?
先看新旧版本的同表比较
1017 官方模型卡保留了与此前 V4.1 Flash 的对照。摘出三项较容易理解的任务,可以看到改进并不均匀:
| 厂商公布的评测 | 此前 V4.1 Flash | 1017 版 | 分数变化 |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
这些是厂商报告的分数,本文没有独立复现。它们说明新版在这组测试中取得进展,却不能合成一个“日常能力提升多少”的总百分比。
尤其不能忽略测试外壳,也就是负责执行命令、调用工具和组织任务的智能体程序。DeepSeek 标注,Terminal-Bench 4.0 使用 Claude Code 外壳,DeepSWE v1.1 使用 Mini-SWE-V2。模型需要与这些程序共同完成任务,成绩并非一段裸提示词的结果。
Terminal-Bench 官方的 4.0 说明还显示,该版本调整了时间、CPU、内存等资源,修复任务并移除了部分题目。这意味着,不能拿旧版本榜单中的一个数字,与 4.0 的结果直接相减,再归因于模型进步。
类似的细节也出现在其他行:HLE 有完整集合与纯文本子集的区别,官方日志注明 ZeroBench-main 采用 Pass@5。看到“超越某模型”之前,至少应先确认双方做的是同一份题、允许几次尝试、使用什么工具。
单价没变,任务成本仍然可能下降
API 单价只是计费的一个乘数。一次任务实际花多少钱,还受输入长度、输出长度、重试次数和工具调用影响。
设想让 AI 修复一个报错:第一次走错方向,第二次重新读文件,第三次才修改成功。即使每百万 token 的价格一样,少一次无效尝试也可能减少总消耗。不过,这只是解释成本构成的假设场景,不是本文对 1017 的实测结论。
DeepSeek 在本次发布说明中强调,升级方向包括更快完成任务和更短输出。它同时展示了 DeepSWE 的成功率与任务成本对照:
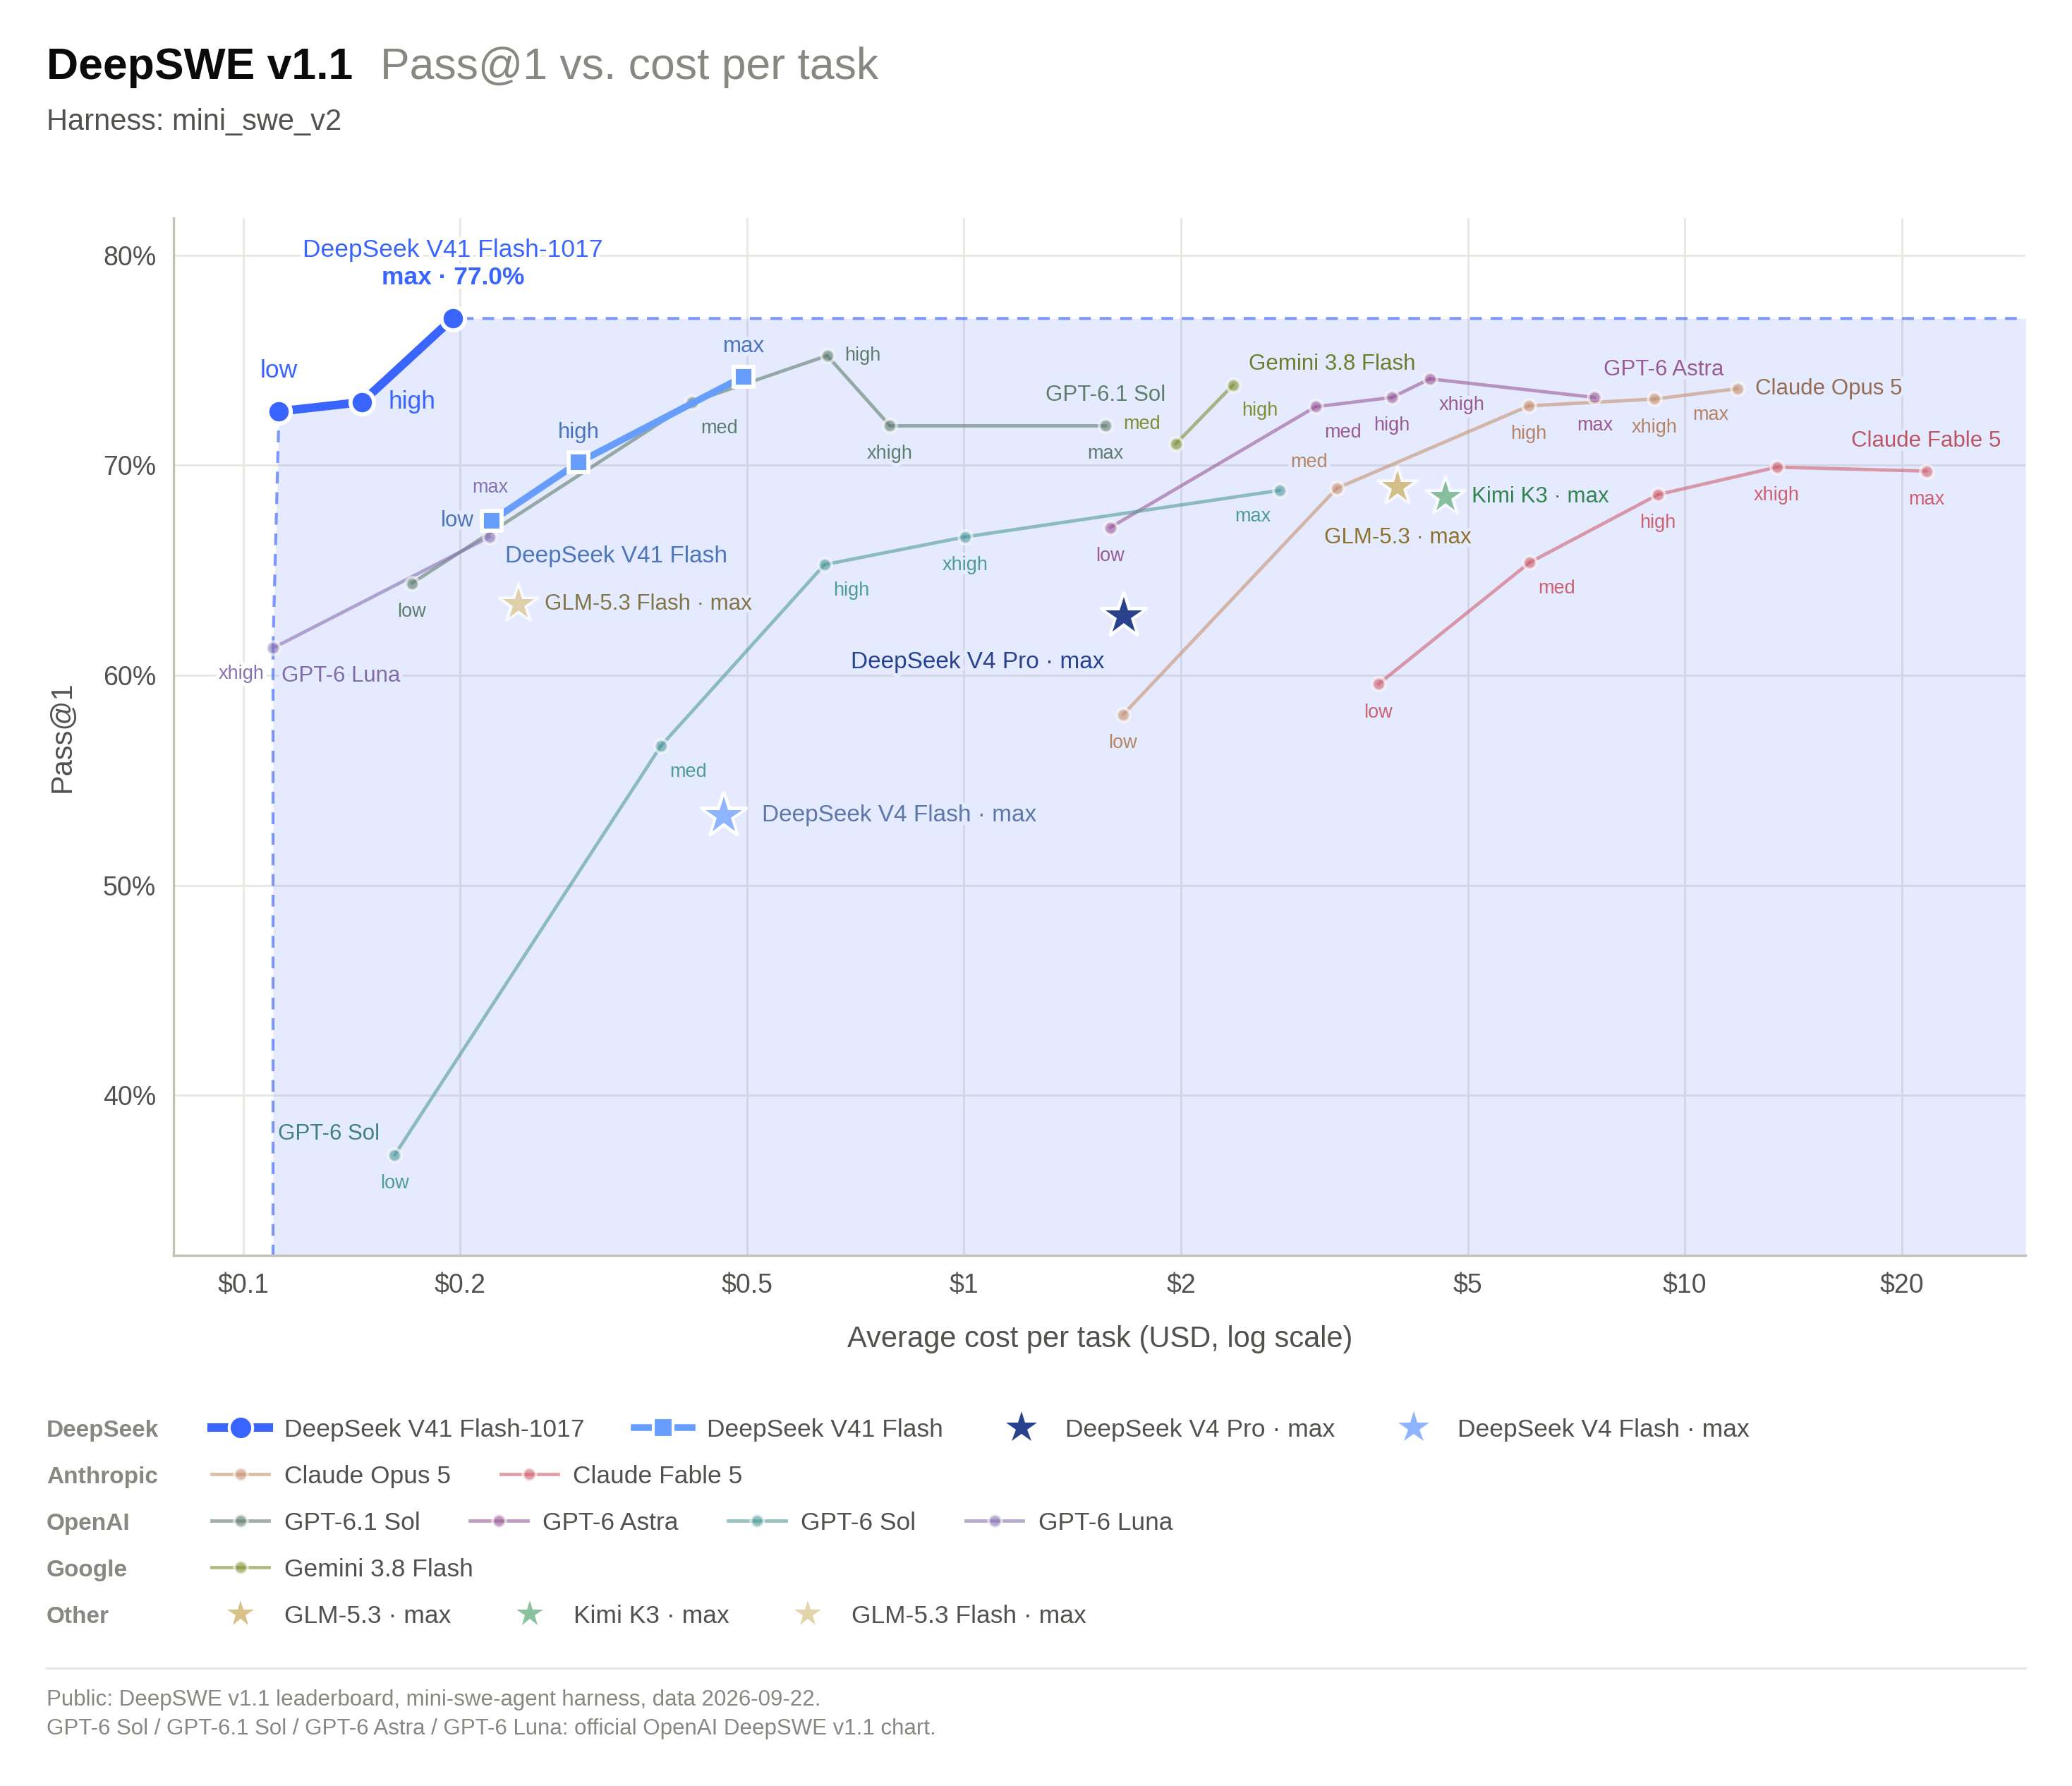
图源:DeepSeek 10 月 17 日发布说明,2026 年 10 月 18 日核查。图中新版测试采用 mini_swe_v2;部分外部对照数据引用 9 月 22 日公开榜单及其他厂商资料,不代表全部模型在同一天、同一外壳下重新测试。
读这张图,可以先看两个方向:越靠左,平均每项任务成本越低;越靠上,测试成功率越高。横轴采用对数刻度,同样一段距离并不代表相同的美元差额。不同思考强度也对应不同点位。
厂商希望说明,新版能够把“做对更多”和“花得更少”一起向前推。这是有意义的优化方向,但图上的平均任务成本不能直接当成你修复任意一个问题的报价,更不能据此承诺个人账单固定下降多少。
对已有用户,最有价值的验证往往很朴素:保留原来能成功、容易失败和经常反复尝试的几组真实任务,在相同材料与设置下记录是否完成、耗时和用量。输出短了却漏掉要求,不能算同等质量下的节省。
还要把模型费用和整套服务费用分开。若使用第三方网关、独立搜索或付费执行环境,附加费用不会因为模型输出更短而自动消失。官方所说的价格不变,首先指其自身 API,也不是对所有转售服务的统一定价承诺。
托管 API 自动切换,自部署要核对交付细节
使用官方网页、App 或托管 API,主要变化由服务端完成。也正因为调用名没有变化,团队在记录测试结果时,最好同时写下日期和已知版本,避免把不同时间的体验都算在同一个旧模型头上。
自行部署的开发者面对的是另一组问题。本次提示编码说明提供 Python 参考实现和测试样例,覆盖多轮对话、工具调用、思考模式和图文交错输入;仓库没有附 Jinja 格式聊天模板。这里是在交付正确组织模型输入的依据,并不意味着所有旧客户端都会自动适配。
配套的 deepseek-recipe则负责请求格式转换、提示编码和输出解析。它的文档明确说,模型推理、工具执行和网络传输仍由接入方提供。装上这个库,不等于已经拥有完整智能体服务。
同样,最小推理实现将自己定位为便于阅读的参考实现,而非生产服务引擎。公开权重、参考代码和稳定运行的线上服务,是需要分别验证的交付层次。
本站此前已经解释过 V4.1 Flash 的缓存与非对称架构。10 月 17 日这条新闻的新增价值,是同一代模型继续调整任务表现与消耗,而非第一次获得视觉能力或重新发布整套架构。
补充阅读包括 51AllAI 的版本报道,其中的开放状态与调用说明已回核官方资料。对于正在使用这个模型的人,值得关注的不是“小版本”三个字,而是自己的任务有没有少绕弯路、稳定交付。
评论