Opus 5.5 降本真正值得看的,是缓存价格和任务消耗
“Claude Opus 5.5 便宜了 40%”听起来很直观,实际上包含好几件事。
9 月 22 日推出的 Opus 5.5,标准 API 输入与输出单价由每百万 token 的 5 美元、25 美元,降到 4 美元、20 美元。两项都是下降 20%。缓存读取则由 0.50 美元降到 0.20 美元,降幅达到 60%。官方发布稿所说典型任务整体成本约低 40%,还考虑了完成工作时消耗更少。
所以,**20%、60% 与约 40% 不矛盾,它们描述的是不同层面。**把它们混成一个包月打折数字,才会误导。
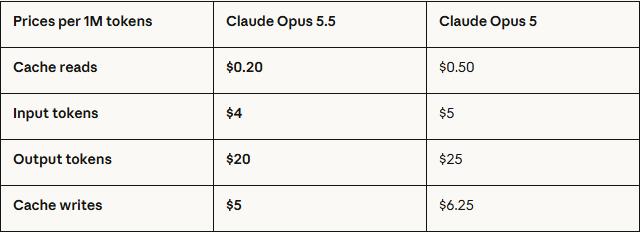
图:Anthropic 发布页的标准 API 价格对照表。它比较的是不同 token 类型的单价,不是订阅套餐价格。
为什么缓存值得单独看?
长任务通常会反复携带前面的材料。模型可能需要多轮处理同一项目说明、工具规则和文件上下文。缓存机制可以减少重复处理部分的费用,但能否命中,以及怎样计费,要看实际请求和服务规则。
用通俗比喻说,第一次介绍项目时,你需要把背景讲清楚;之后如果对方仍然保留了这段背景,你不必每次都从头讲。这个比喻能帮助理解缓存的用途,却不代表每轮请求都免费,也不代表所有上下文都会自动命中。
因此,AI 智能体的账单,可能受缓存价格影响很大。一次简短问答几乎没有重复材料,未必享受到同样程度的改善。平均降本比例需要结合你的工作类型。
更低单价之外,还要看返工
一个模型每次调用很便宜,却需要反复重问,最后还要花大量时间修正,整项工作的成本不一定低。
反过来,较贵的模型如果能减少漏项、准确理解资料,可能更适合复杂工作。这里的“可能”很重要:不能用产品档位替代事实验证,也不能根据厂商个别演示计算所有用户的收益。
Opus 模型页与5.5 API 文档都把较长的编码和知识工作作为主要方向。官方工作场景讲解则提供了理解实际用途的另一份材料。
对小团队而言,值得记下的不只是调用费用,还有“得到能交付的结果用了多久”。资料整理、代码检查和报告制作都会产生人工验收成本,这部分经常被漂亮的演示省略。
用一个简单算式,避免被折扣数字带着走
假设标准 API 请求恰好使用 10 万输入 token、1 万输出 token,且忽略缓存和其他收费项,按 4 美元与 20 美元的单价计算,费用是 0.4 加 0.2,合计 0.6 美元。
这只是解释计费的假设,不能当成“整理一份报告只要 0.6 美元”的实测承诺。真实任务的材料长度、思考消耗、多轮调用与工具使用都可能不同。
快速模式也要另外算。发布稿列出的快速模式输入、输出单价更高,不能用标准模式价格估算。速度收益是否值得额外费用,应与你的等待成本比较。
升级并非只替换模型名字
Opus 5.5 变化说明列出了不兼容变化:例如某些旧的思考开关、强制工具调用方式,不能继续原样使用。
迁移指南还提醒,默认努力级别与上一代不同。即使请求没有报错,省略设置后的行为也可能变化。
这些信息与价格新闻同样重要。一个接入成本更低的模型,如果让原系统请求失败,团队仍需要花时间修改和验证。降低运行成本与迁移成本是两本账,不能只看前一本。
对不写程序的人,这件事也有启发:同一个 AI 名称,背后可能有不同产品入口、默认设置和套餐。比较之前,先确认是在比较相同工作方式。
这次降本会把竞争带向哪里?
我们的判断是,高能力模型的竞争正在更多地围绕“完成一项工作多少钱”。这会推动厂商同时改进单价、用量效率与产品工作流,也让企业更愿意测试持续使用,而不只是偶尔试一次。
但仍然不该宣布所有小模型都失去价值。清晰、重复、容易验收的任务,较轻的模型可能已经足够;复杂工作则值得测试更强的选择。
这篇文章没有独立跑分。它拆解的是官方价格与文档里的区别,帮助读者把新闻里的百分比放回自己的成本结构。若日常使用海外 AI 工具时关心连接稳定性,本站的网络服务选择参考可以作为另一个维度的阅读;它不能改变模型套餐和官方资格。
评论