Sonnet 5.5 的一个反直觉细节:思考开到最大,成绩反而可能下降
看 Claude Sonnet 5.5 的发布页时,最值得多停几秒的地方不是大标题,而是一条脚注。
Anthropic 解释,在 FrontierCode 测试里,Sonnet 5.5 的 Max 设置分数低于 Xhigh。一些案例中,模型做了额外代码审查,导致超时或增加了任务范围之外的修改;评测因此扣分。官方发布说明没有把这一点藏起来。
这给“思考开到最大,结果一定最好”的直觉泼了一盆冷水。不是模型不够努力,而是努力的方向可能超过需求。
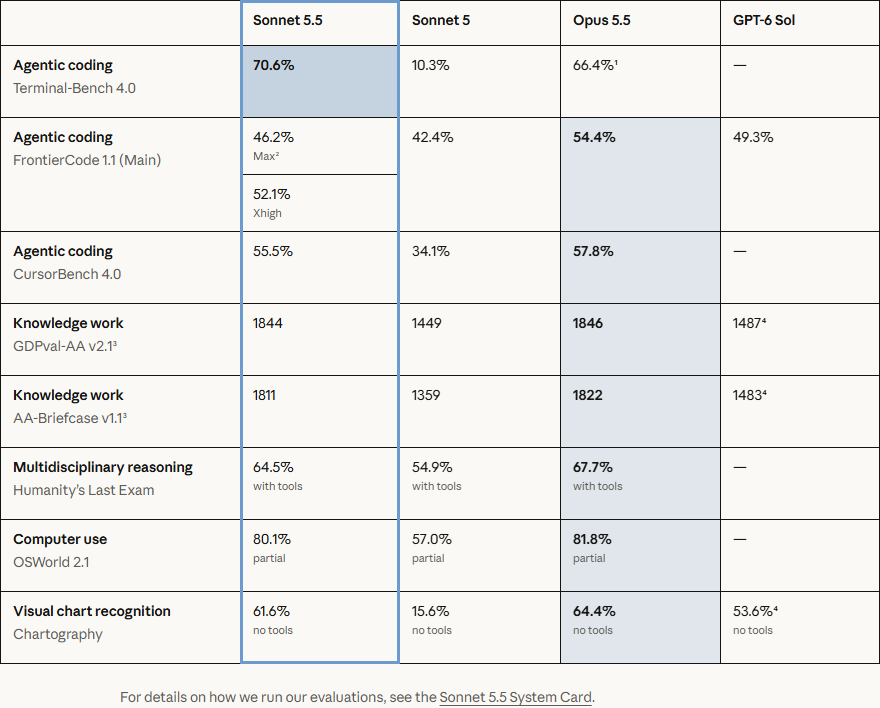
图:Anthropic 官方 Sonnet 5.5 性能表截图。FrontierCode 的 Max、Xhigh 两行应连同原页脚注阅读,不能只摘最高分。
一次更新,两个值得分开看的消息
Sonnet 5.5 在 9 月 28 日推出。官方强调输出速度提高 30% 以上,典型任务费用最多下降约 30%;但 API 单价维持与 Sonnet 5 相同。这是“用更少的消耗做同一件事”的主张,不是包月订阅统一降价。
另一个消息藏在行为变化里:模型不仅要解决问题,还要判断做到哪里应该停。给一个小缺陷修复任务,顺便整理整个模块,可能看起来很负责,却可能破坏开发者原本限定的修改范围。
官方成绩属于厂商评测。本文关注的是它公开解释的现象,没有把某一次成绩延伸成“Sonnet 比 Opus 全面更强”的结论。
多做一点,为什么可能是坏结果?
可以把它想成请人修门锁。门锁修好后,如果对方未经沟通又换了门框、重做墙面,哪怕工艺不错,你也可能不满意:预算变了,工期变了,原本要保留的东西也变了。
软件工作里,这种额外修改更不容易一眼看出来。它可能扩大审查范围,影响测试,或者让一个本该快速完成的任务拖延。对 AI 来说,“改得漂亮”和“完成用户要求”不是完全相同的标准。
这也解释了为什么推理强度要结合任务,而不是一律拉满。需要探索和比较的难题可以给更多空间;边界清楚的小任务,则应该让模型知道哪些内容不该动。
默认设置的差别,足以改变一次体验
Sonnet 5.5 模型文档描述了它的 API 规格与默认推理设置。变化说明还列出与上一代存在的不兼容变化。
因此,在不同入口里试用同一个名字,体验未必相同。聊天产品、Claude Code 和开发者 API,可能有不同工具和默认设置。别人展示的结果需要连同入口一起理解。
对于日常使用者,最实用的改变往往不是学习所有参数,而是把任务写清楚。比如让它整理一份文档时,说明保留哪些术语、不补写缺失事实,以及输出应该方便你怎样检查。
对于开发者,升级不应只改一个模型名就结束。原请求形状能否继续使用,输出如何被应用读取,都值得检查。具体迁移应依据当前官方文档,而不是按旧教程猜。
这会改变普通人的使用选择吗?
会影响选择,但不必夸大。Sonnet 系列的日常定位,使速度与修改成本格外重要。如果一项工作要反复对话,响应快一些、结构更清楚,可能比一次生成很长的答案更有价值。
Tom’s Guide 的报道也从日常工作角度讨论这次更新。我们把媒体意见当作观察方向,产品可用性则核对Sonnet 官方页面。
还有一个不能跳过的限制。透明度报告讨论了模型的诚实性和事实错误表现:能力改善并不等于不再出现错误。尤其是没有联网查询时,看起来合理的答案仍可能不准确。
我更愿意记住这次发布留下的那个小提醒:AI 能力越强,给它清楚的边界越有价值。不是每个任务都需要一整套宏大计划,也不是每次都应该做更多。
想了解同一代另一款模型的成本变化,可以接着看Opus 5.5 的价格拆解。本文依据截至 2026 年 10 月 7 日可读取的发布稿与补充资料,没有自行复现这些评测。
评论