GPT-6.1 Sol 上线:OpenAI 把复杂任务的成本竞争推到了日常工作
AI 厂商最近不只在推出更强的旗舰,也在回答另一个问题:普通工作能不能长期负担得起?
9 月 29 日,OpenAI 在更新记录中公布 GPT-6.1 Sol 进入 Codex 与 ChatGPT Work。它的官方定位是以低于 Astra 的成本处理复杂工作,尤其是持续时间较长、反复进行的代码、应用和文档任务。
这句话的关键词其实是“反复”。一次演示成功,很容易吸引眼球;同一类工作每天都能做,费用和验收方式才会成为决定因素。
OpenAI 的模型分工越来越清楚
当前模型说明将 Astra、Sol 与 Luna 放在不同工作定位上。简单理解:最困难的复杂工作、兼顾成本的持续工作、边界明确的大量重复任务,需要的资源不相同。
这不是说三种模型之间存在一条绝对准确率阶梯。特定材料、工具和设置都可能影响结果;官方“接近 Astra”的描述也不等于每项能力完全一致。
我们认为,这种产品分工反映了一个行业变化:AI 逐渐从聊天工具进入工作流程。用户需要的不只是更好的答案,还包括长期使用时能控制的费用、稳定入口和容易交接的结果。
同期Opus 5.5 的降本也在强调任务消耗。这些消息可以一起观察,但没有相同测试条件,就不宜拼出谁性价比最高的万能排名。
模型上线,为什么有人还是看不到?
答案不只有“还没更新应用”。OpenAI 的套餐与可用性说明区分了产品入口、套餐与工作区规则:GPT-6.1 Sol 在 Work 和 Codex 中提供,而不是普通 Chat;企业和教育工作区还可能需要管理员启用。
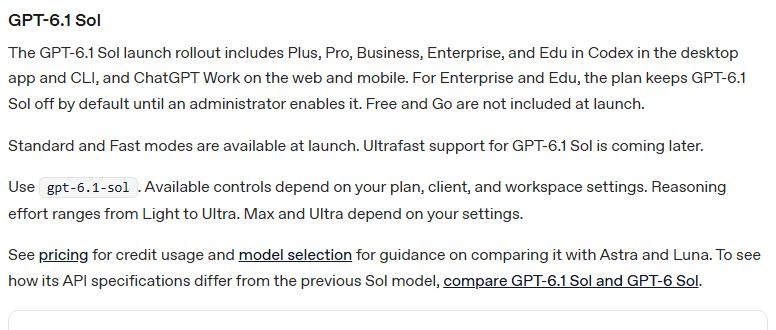
图:OpenAI 官方模型说明中的 GPT-6.1 Sol 开放段落截图。它列出的是产品访问条件,不是网络连接要求。
所以,比较别人截图与自己的界面之前,先确认是在同一产品入口、同一账号类型下操作。模型名称出现于新闻、账号具备使用资格,以及界面实际显示入口,不必然同时发生。
这也会影响第三方服务的宣传。如果某个服务使用相同名称,仍需要核对它的实际接入方式和提供内容,不能只凭名称推断具备官方产品全部工具。
规格大了,新闻知识并不会自动变新
API 模型页提供了上下文、输出与知识截止等规格。一个特别值得普通读者理解的区别是:上下文容量可以增加处理材料的空间,但不会把没提供、没搜索到的新消息自动装进模型记忆。
如果你让 AI 写最新报道,应该让它实际查询来源。模型能够分析长资料,不代表它在没有检索时知道今天发生了什么。
同样,工具支持也要看所用接口。GPT-6 指南区分了接口与工具调用方式;API、Codex 和聊天产品不能简单当成相同环境。
对普通用户而言,重要的不是背下所有技术名称,而是确认工具实际上完成了哪些动作。说“文件已修改”时能否看到文件,说“消息已核实”时能否打开来源,这些比模型自我描述更有价值。
小项目,往往比大口号更能说明问题
假设你维护一份持续更新的操作手册。每次有新流程,都需要阅读材料、找出变化、统一术语,并保留仍然有效的内容。
这类任务适合观察持续工作体验:模型有没有遗漏旧限制,是否把计划中的功能写成已经上线,结果是否方便核对。如果这些问题减少,费用再合理,升级就有实际意义。
但任务也可能只是简单改几个词,较轻的工具已经足够。模型分工的意义是多一种选择,不是要求每项工作都用同一个更大的版本。
还应该继续观察什么?
OpenAI 产品更新汇总提供了后续变化入口。我们会更关注不同产品的开放是否扩大,实际用户在长期任务中的结果,以及产品如何解释费用与工具能力。
现在能够确认的是 GPT-6.1 Sol 已进入相应产品路线。能否成为你的常用工具,要看实际访问条件与工作收益,而不是只有版本号。
查阅海外 AI 公告或进行持续任务时,连接稳定性也会影响体验。如果你需要比较这一层面的服务,可以阅读站内网络线路参考;模型资格和地区支持仍要分别核对。
评论