Qwen3.8-Omni 从“看懂视频”走向“做出成品”,难点在哪里?
让 AI 告诉你一段视频讲了什么,和让它交出一份字幕、图文笔记或剪辑成品,中间还有很长一段路。
Qwen3.8-Omni-Flash 想往后一件事走。官方发布页显示 9 月 18 日的发布信息;Qwen 团队的论文则于 9 月 22 日提交。报道时要区分产品消息与论文日期,不能把它们当成同一次发布。
这次值得看的是模型与工具放在一起的方式。原生多模态理解仍然重要,但行业正在要求 AI 不只描述材料,还能组织步骤、调用工具,再把结果交出来。
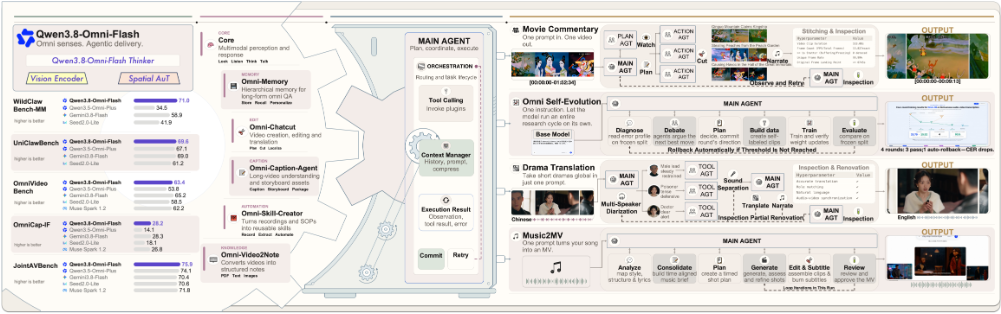
图:Qwen 官方发布页的模型与生产流程示意图截图。右侧展示不同创作流程,不能理解为所有聊天入口都包含这些工具。
从一段教程视频开始看,会更容易理解
假设你想把一段自己录制的教程整理成图文笔记。最初的“看懂”,包括识别画面、听清说明、知道关键步骤出现在什么位置。
接下来要选帧、整理顺序、对应文字、排版,并生成文件。任何一环出现问题,都会影响最终笔记:截图可能选错,操作名称可能翻译不一致,导出的文件也可能无法正常阅读。
因此,一句“模型理解视频很强”,不能代表整个工作流可靠。结果需要分阶段检查,而且应该能回到原视频找到对应位置。
这就是模型能力与 Agent 系统能力的区别。模型提供理解和规划,工具完成文件处理;系统还要管理上下文、权限和错误状态。
官方论文强调了什么,项目又补了什么?
论文把原生多模态理解、较长任务与实时交互放在一起,也介绍了配套框架。它展示的是研究与系统方向,不能自动视为某个消费产品已开放的全部功能。
Qwen-MM-Plugins 项目把不同能力拆成可选择的组件,涉及材料读取、视频处理、笔记和记忆等场景。安装说明又补上了依赖与接入条件。
这两份材料很有价值,因为它们让“能做什么”进一步变成“要准备什么”。有的能力需要模型服务凭据,有的需要媒体处理工具;不是获得一个模型名,就自然拥有所有制作功能。
我们没有在本文安装或复现实验,也不把演示中的完成效果写成自己的实测。对准备使用的人来说,项目文档里的依赖和限制,应与演示一起看。
视频翻译,比翻译一段文字复杂得多
文字翻译主要处理语言;视频翻译还可能涉及说话人、时间位置、字幕同步、音色与原片画面。
如果系统把两个人的台词混在一起,文字即使流畅,结果也不对。如果字幕没有对齐,观众理解仍会受影响。声音重建和配乐还涉及素材授权,不是技术上能处理就可以随意公开发布。
因此,评估创作能力时,成品质量要拆开看。语言准确、位置正确、文件可播放、素材有授权,缺少任何一项都可能让作品无法交付。
实时助手的难点,甚至不止音视频
Qwen-Live-Harness描述实时音视频交互、后台任务与记忆。配置文档还交代了画面来源、捕获方式、权限和服务区域等设置。
这意味着一个真实助手必须知道何时读取画面、哪些动作可以做,以及怎样处理长期记忆。模型响应快,只解决了其中一部分。
我们认为,这次路线的行业意义就在这里:多模态 AI 正从“展示感知能力”,进一步接受工作流程的检验。用户最终关心的是成品能否使用、失败在哪里,以及能不能方便修改。
创作者可以怎样判断新闻里的承诺?
先问自己要交付什么。只是提取视频重点,与制作带字幕、配音和剪辑的成片,所需流程完全不同。
再看演示有没有说明材料、工具、人工介入与输出文件。一个精心挑选的案例可以说明方向,但不能代表所有影片、口音和布局都会有相同结果。
准备尝试时,从短片、少量说话人和清晰目标开始更容易核对。并不是给 AI 越多素材越好,材料标注和文件管理同样重要。
Qwen3.8-Omni 这条消息真正吸引人的地方,是试图缩短“理解材料”和“完成作品”之间的距离。距离有没有缩短,要看完整流程,不只是看模型说得有多明白。
评论