DeepSeek V4.1 Flash 的看点不只在看图:长任务为什么要省缓存?
AI 跑一个长任务时,不只是每一步要计算,还得保留前面读过的材料。项目越长,历史越多,保存和重复处理这些信息的成本也越显眼。
这正是 DeepSeek V4.1 Flash 的一个值得关注的方向。9 月 10 日的官方发布稿介绍了原生视觉、输入输出不对称结构,以及更小的 KV Cache。相比只写“模型更聪明”,这些变化更接近长任务实际消耗的来源。
缓存,为什么会进入模型新闻?
KV Cache 可以粗略理解为模型处理上下文时保留的中间信息。它不是普通用户电脑里的浏览器缓存,但同样服务于“不要反复从头算”的目标。
当 AI 多次阅读同一个项目、调用工具,再继续处理后续步骤,上下文存储会变得重要。缓存所需资源更少,有机会降低服务压力与费用;最终改善多少,还取决于实现、硬件和任务。
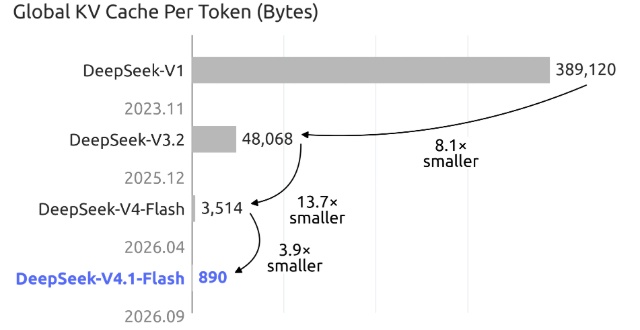
图:DeepSeek 官方发布稿中的历代 KV Cache 对照图截图。数值采用厂商展示的特定指标,不能直接换算成所有用户的费用降幅。
发布稿用上一代模型作为参照,描述了显存与存储需求减少。我们没有自行复现这些数据,因此把它作为官方技术主张阅读,而不是宣称你每月账单会按相同比例下降。
这一点并非故意保守:资源指标、API 单价和一次工作总费用,是不同概念。长任务如果反复走错方向,基础资源再省,也可能消耗许多额外请求。
输入与输出不对称,是另一处变化
官方介绍 V4.1 Flash 采用 Causal-Encoder-Decoder 结构,并给出约 5520 亿总参数、输入激活 80 亿、输出激活 160 亿的描述。
对非技术读者,可以先理解为模型没有要求输入和输出两阶段承担完全相同的计算安排。它尝试根据阶段设计不同结构,服务于速度、吞吐和能力之间的平衡。这个解释只用于理解方向,不是完整架构原理。
它属于新一代模型结构路线,也不能由“Flash”这个名称推断为普通电脑上的轻量模型。产品叫得轻快,与部署需要的资源,是两件事。
视觉能力怎样进入已有程序?
视觉文档说明图像输入方式;Responses API 文档也明确了相关模型与图像处理支持。能力是否能被你的程序使用,要看接口和请求形状,而不只是模型宣传。
现实材料很少只有纯文字。一份说明可能包含截图,一张表可能带合并单元格,网页问题可能需要同时看页面与报错信息。原生视觉让这些任务少一段人工转述,但仍然可能看错细节。
对于数字、人名、代码和小字,保留原材料并核对结果仍然必要。视觉理解并不等于图片生成,不能从“能看图”推断它可以制作任意图片。
思考模式文档则提醒另一层差别:任务还会受到思考设置和调用方式影响。比较新旧体验时,应尽量保持材料与设置一致。
旧 API 名称,为什么需要重新查?
更新日志给出的最新 Flash 调用名称是 deepseek-flash,并描述旧 Flash 名称暂时映射到新版本。
更值得纠正的是 Pro 的说法。最初发布页出现过 Pro 请求改路由的安排,但当前更新日志明确表示继续提供 V4 Pro API,并保留原计费方式。两份官方资料存在时间与维护差异,不能只截图最初的计划就宣布 Pro 已停止。
核对时还参考了8 月 V4 Pro 正式版说明,用于区分先前发布、后续变化和当前文档。这个例子说明,多看几份相关资料很重要:消息发布后的修订,可能比发布当天的标题更影响使用。
这条更新给行业留下什么问题?
我们的理解是,国产模型竞争越来越多地触及长任务的底层成本。视觉、工具调用和缓存共同决定系统能不能持续处理工作,而不是各自独立的演示功能。
接下来值得观察的,是这些设计能否在更多任务和部署环境中获得验证,以及接口维护能否让既有用户平稳过渡。
对于普通读者,没必要记住全部架构缩写。先记住两个区别就足够:缓存变小不等于所有费用等比例降低;旧名称还能请求,也不等于背后的模型永远不变。
相关的另一条路线是Qwen3.8-Omni 的音视频工作流。它更强调把多模态材料转成成品,可以与 DeepSeek 的结构和接口变化分开观察。
评论