OpenAI 披露 AI 辅助传播行动:假记者为何能进入真实媒体?
一篇文章有作者姓名、人物简介,还刊登在真实媒体上,通常比匿名帖子更容易让人信任。OpenAI 最近披露的案例,恰好把风险放在了这层信任上:署名和机构可以是假的,替它们发表内容的人却可能是真的。
2026 年 10 月 8 日,OpenAI 公布两项“虚假门面”传播行动的调查,称已经封禁来自俄罗斯和伊朗的相关 ChatGPT 账户。本文报道的是这次调查披露;行动本身持续更久,并不是 10 月 8 日突然发生。
它给 AI 行业提出的问题,也超出了模型能写多少内容:当写作、翻译和行政工作更容易完成,谁来确认内容背后的身份与组织?
七个署名,进入真实的发表渠道
CNA 在 10 月 9 日的报道整理了 OpenAI 所称的“Bogus Bylines”行动。操作者使用七个虚构的记者身份,借助 ChatGPT 修改英文稿件、准备投稿邮件,向真实媒体提供内容。
OpenAI 找到接近 100 篇以这些署名发表或转载的文章,分布于大约十多家网络媒体,时间从 2025 年 7 月延续到 2026 年 10 月。这个数量包括发表与转载,不能直接写成“100 篇不同原创文章”。
需要谨慎区分两件事:身份和来源被隐瞒,不等于调查已经证明每篇文章的每个事实都虚假。 报告展示的是借虚构作者进入发表渠道的操作方式,也不能据此断言某种政治观点本身就是 AI 操纵。
部分媒体随后通过自己的社交账号推广文章。这使操作者得到的是一个已有机构的分发渠道。读者看到的可能是可信媒体的正常分享,而不知道署名背后的人是谁。这里的分析重点是信任怎样被转移,不是把真实媒体的全部内容一并判为不可信。
一家“智库”,也可能有认真工作的真实员工
另一项行动叫“Dark Clark”。CyberScoop 的报道指出,OpenAI 从 ChatGPT 生成的内部工作报告中看到招聘、薪酬、解雇等细节,因此判断操作者可能实际控制了拉丁美洲的 Social Research Center,而非仅仅与它有普通合作。
按照 OpenAI 的判断,当地工作人员可能不知道自己服务于俄罗斯背景的行动。他们仍会采访、研究和写作。报告认为该机构网站上的大部分内容看起来是原创,这也是它区别于简单复制文章的网站之处。
这个案例提醒我们:有真实员工、真实采访或原创文字,仍不必然说明一个机构公开了真实的控制关系。反过来,也不能把受雇而不知情的人都当成操作者。身份、内容和组织归属,需要分别核对。
同样重要的是归因边界。调查提到操作者来自哪里、关注哪些组织,并不等于已经证明某个政府部门或情报机构下达了命令。CyberScoop 明确指出,报告未把该行动归于具体的俄罗斯政府或情报机关;对伊朗行动,OpenAI 也未确定具体操作者。
“传播突破等级 5”到底说明了什么?
OpenAI 对 Dark Clark 给出 Category 5 评级,对 Bogus Bylines 的文章渠道给出 Category 4;后者的社交评论渠道只有 Category 2。同一行动通过不同渠道传播,表现可以很不一样。
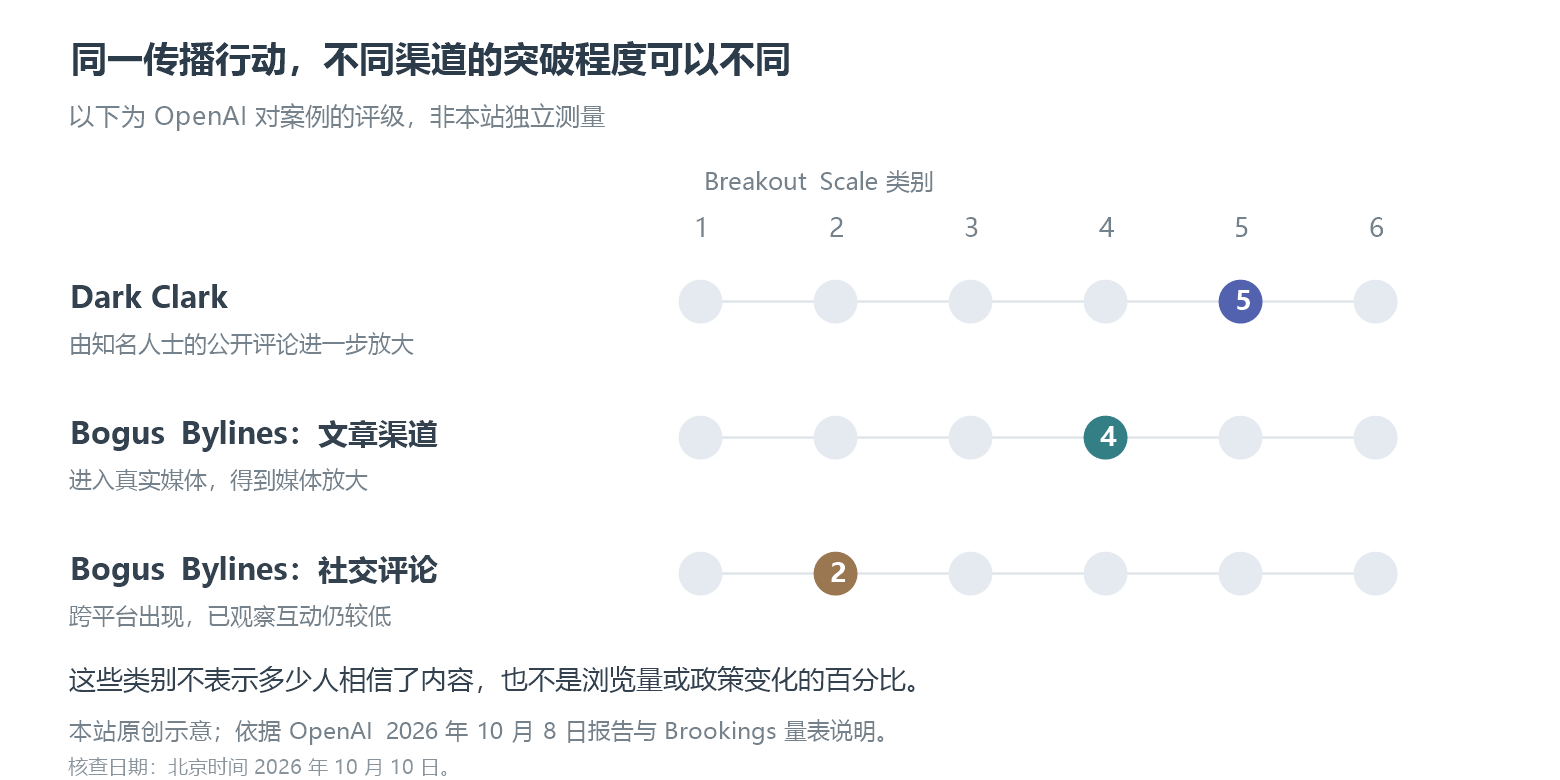
图:本站原创示意,依据 OpenAI 10 月 8 日报告及 Brookings 对量表的说明绘制,核查于北京时间 2026 年 10 月 10 日。等级是公司的案例评定,不是本站实测,也不表示多少读者相信了内容。
这些数字采用 Breakout Scale。Brookings 在 2020 年发布的原始说明把传播行动分成六类,观察它是否跨越平台、群体、媒体与公共讨论。Category 4 涉及主流媒体放大,Category 5 涉及知名人士等进一步放大。
因此,“5”不是 5 分制满分,也不是“影响了六分之五的人”。它不能直接证明读者改变立场、政策改变,或者这类行动已经无处不在。
CNA 的报道也保留了调查里的限制:操作者曾把不属于自己的活动算作成绩,部分内部声称的成果无法被公开资料证实。OpenAI 对伊朗社交评论的观察则显示,已找到的互动较低。大量生成内容、媒体潜在受众和真实说服效果,是三种不同的数字。
公开核查能证实哪一层?
为了理解报告引用的外部证据,我们另外打开了两份当地核查材料。Lupa Media 的核查页面检查了一段冒用电视台身份的视频:查原媒体档案、做反向图片搜索,并核对所谓企业的登记资料。其页首和正文对相关年份存在不同表述,本文不据此重建该视频首次出现的时间线。
Bolivia Verifica 的 5 月 26 日核查则记录了传播中的停水传言及供水企业的否认。这是早于本次披露的核查记录,不是 10 月新发生的停水事件。
这些材料可以说明相应虚假内容曾被查证、相关说法受到否认,却不能单独证明幕后账户属于哪个群体。把公开内容与被封 ChatGPT 账户联系起来,主要仍依赖 OpenAI 的调查和非公开数据;本文没有独立取得这些账户记录。
对读者来说,比较有用的变化是核查重点要扩展。作者简介不能只看本人的自述,还要看其他可验证的记录;引用某个机构时,要追问其控制和资助关系;遇到惊人的“泄露文件”或带媒体标志的视频,要回到真正的发布渠道找原件。这些做法有助于判断证据,不能保证每次都识别出隐蔽行动。
这也补充了站内ChatGPT Intelligent UI 产品解读提到的一点:表达更流畅、界面更清楚,解决的是阅读体验,并不能自动确认证据可靠。
这次调查最值得记住的细节,是 AI 既被用于面向公众的文字,也被用于后台报告和工作协调。风险并不只出现在一眼能认出的合成图片里,还可能藏在普通文章的署名和普通机构的组织关系中。追问来源,比仅凭文风判断“像不像 AI 写的”更贴近这两个案例暴露的问题。
评论