EmbeddingGemma 2 发布:7.4 亿参数,让手机同时搜索照片和录音
想在相册里找到“那张靠窗晒太阳的猫”,你通常记不住文件名;想在一堆录音里找“讨论下一季度预算的那几分钟”,也未必知道原话用了哪些关键词。
Google 在 2026 年 10 月 6 日发布 EmbeddingGemma 2,把文字、代码、图片、视频和音频放进同一套语义表示体系。这个本周推出的开放模型,完整配置只有 7.4 亿参数,面向手机、笔记本等本地设备。
它的价值在于为应用提供一种新的“找东西”方式。文件没有准确标签、不同内容类型分散在各处时,检索仍有机会从意思和画面入手,而不只匹配文件名。
它怎样让一句话找到一张照片?
Embedding,也就是嵌入,可以理解为一份用于比较内容的数字表示。它不是把照片压成另一张小照片,也不是直接写出一篇答案,而是把内容编码成向量,再比较向量的相似程度。
官方模型卡说明,EmbeddingGemma 2 把不同输入映射到统一的 768 维空间。文本查询与图片来自不同形式,但可以比较它们表示的语义是否接近。一次搜索由此不必先把每张图片描述成文字,再做文字检索。
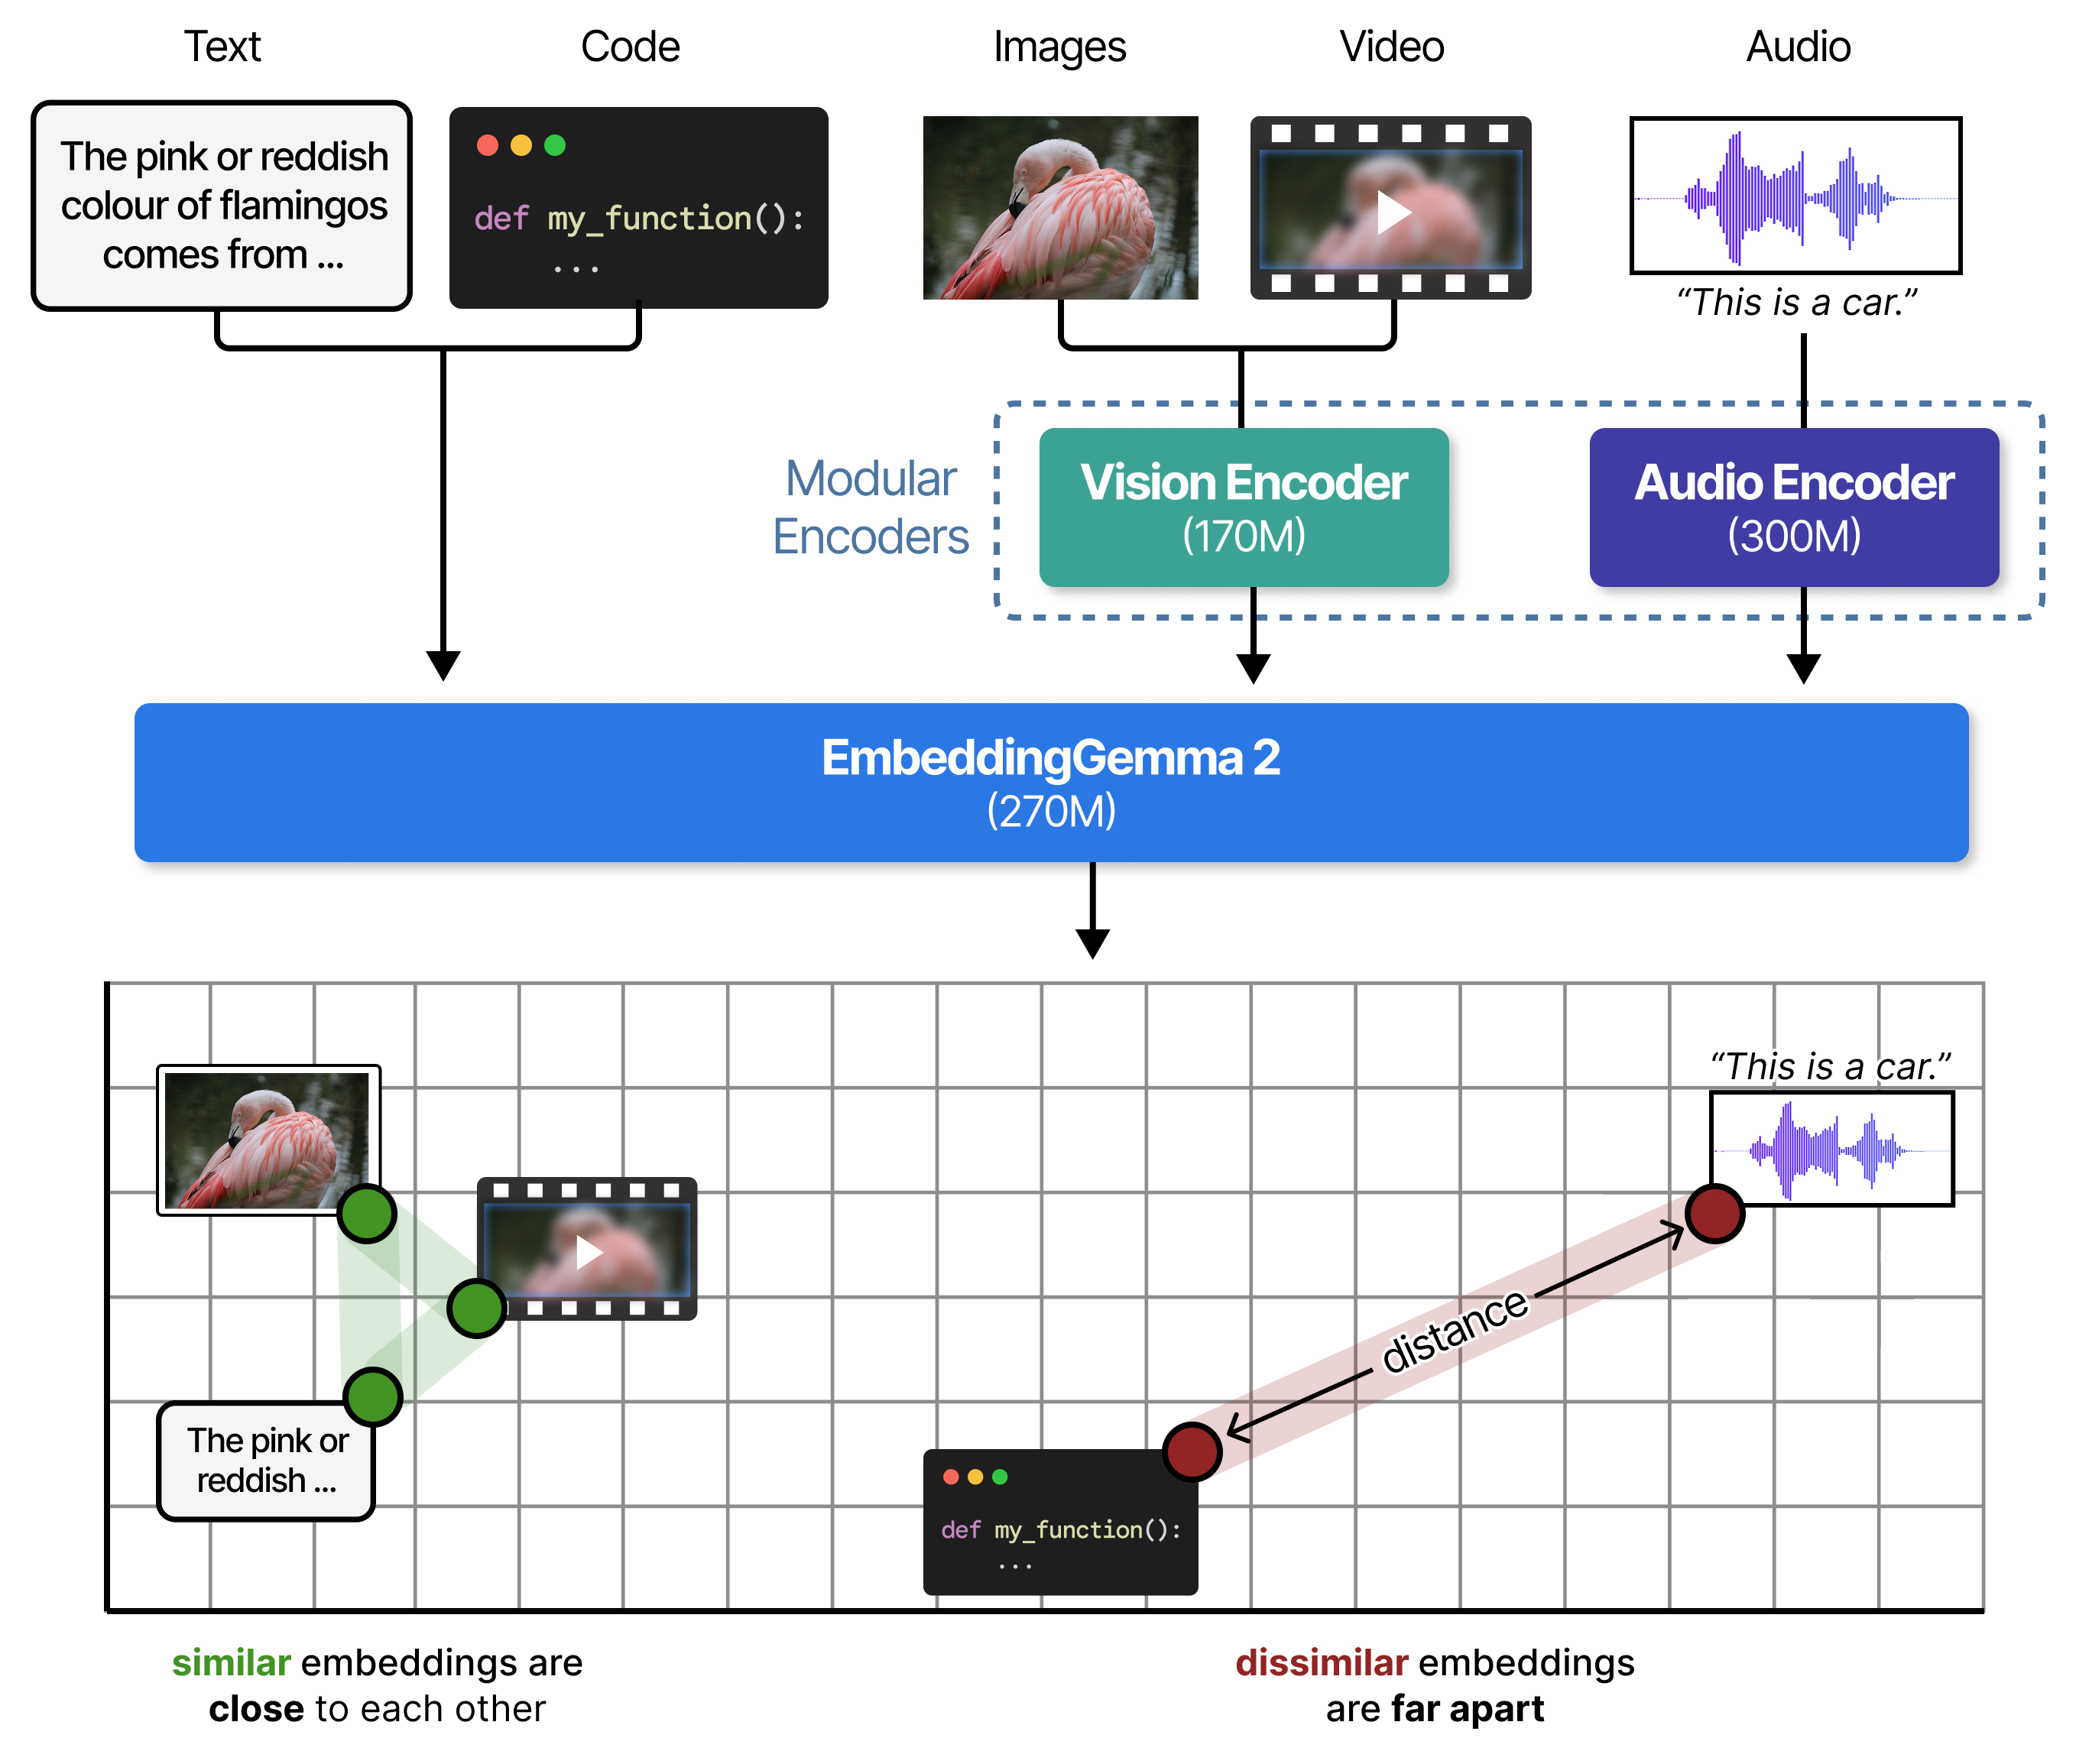
图:Google Developers 在 2026 年 10 月 6 日开发者指南中提供的原始架构图,英文标注保留;核查于北京时间 10 月 10 日。下半部分的二维位置用于解释相似性,不是模型 768 维向量的实际坐标。来源:官方开发者指南。
Google AI Edge 团队的发布说明给出了两个展示场景:Instant Media Search 用自然语言或示例图片搜索本地媒体;Video Moments Finder 用描述找到视频中的相关时间点。它们说明模型能怎样融入产品,不等于本站已经测试过检索准确率。
例如,在一段家庭录像中寻找“有人吹灭生日蜡烛”的片段,应用先为媒体内容建立索引,再把查询与索引比较。模型并不需要生成一段新视频,任务是把已有材料里更相关的位置找出来。能否找准,还取决于素材、索引方式和应用本身的实现。
7.4 亿参数,可以按资料类型拆开加载
官方开发者指南把配置分为四种。文本与代码使用基础部分,需要图片或视频时加视觉编码器,需要音频时加音频编码器。
| 使用的内容 | 加载参数量 |
|---|---|
| 文本、代码 | 2.7 亿 |
| 文本与视觉 | 4.4 亿 |
| 文本与音频 | 5.7 亿 |
| 完整多模态 | 7.4 亿 |
这是一种按需加载组件的设计。只有文字资料的应用,不必一直把视觉和音频部分放进内存;以后加入照片或录音,再加载相应组件。参数量表示配置规模,不能直接换算成每台设备的实际内存或速度。
“本地运行”也要落到整个流程上。LiteRT-LM 的嵌入模型文档提供了面向设备端的运行接口,支持检索、分类和聚类等用途。查询与文档还需要使用合适的任务说明,让模型知道是在找资料,还是把相似内容分组。
如果应用在本机完成编码、存储和匹配,原始资料可以留在设备上;如果后续把检索结果交给云端模型回答,就仍有数据传输。一个模型支持本地推理,并不能代替对应用后续行为的核对。这是理解整体产品流程的边界,而不是对某款应用的隐私实测。
向量缩到六分之一,省的是什么?
EmbeddingGemma 2 的另一项变化,是支持把输出向量从 768 维缩为 512、256 或 128 维。它使用的 Matryoshka Representation Learning,来自2022 年提出的研究,核心思路是在同一份表示里安排不同粒度的信息,让较短的前缀也能用于下游任务。这是技术背景,不是本周新发表的论文。
假设存储格式与数量不变,128 维向量保存的数字只有 768 维的六分之一。这能减少向量部分的存储,但不意味着模型权重、原始媒体、数据库索引和应用总内存也一起缩到六分之一。
更短也有代价。模型卡的结果与说明指出,128 维会明显影响多模态检索质量;开发者指南更倾向把它用于大型文本索引或第一轮候选筛选。对看图找细节、视频片段定位这类任务,不能只看“省六倍”就默认选择最短向量。
可以把它想成地址的精细程度:粗略地址足以先找出附近的几个候选,详细地址更有利于区分具体位置。这个比喻用来理解取舍,向量的数字并不是现实地址。
从“会回答”到“先把资料找对”
这类模型也能放进检索增强生成,也就是 RAG 的流程:先从资料库找出相关内容,再让生成模型结合这些材料作答。它改善的是找资料的基础环节,回答的事实准确性还要看资料质量和后续模型。
对开发者而言,开放权重与 Apache 2.0 许可,让这次发布具备集成和调整的空间。对普通用户而言,更容易感受到的可能是相册搜索、录音定位和个人资料库,而不是一个新的聊天入口。文章所引用的规格和效果来自官方文档与演示,本站没有独立复现其性能测试。
与前几天站内报道的微软与 NVIDIA 本地 AI 方案一起看,可以发现行业既在改进设备,也在缩小适合放进设备的模型。它们是不同发布,但都在把更多处理环节移到用户身边。
如果阅读英文开发文档或获取开放模型时连接不稳定,可以参考站内机场推荐与线路选择。网络连接不改变平台支持地区、账号资格或模型许可要求。
EmbeddingGemma 2 最值得观察的后续,是应用能否把这种跨媒体检索做成稳定、清楚、真正有用的功能。对记不住文件名的人来说,能找回正确的资料,本身就是一次实在的 AI 进步。
评论