NVIDIA 发布 Dory 4B:同一份权重多算几轮,小模型能变强多少?
一个 40 亿参数的模型,能不能不换权重,只让内部网络多算几轮,就把难题做得更好?
NVIDIA 在 2026 年 10 月 16 日发布的 Nemotron Labs Dory 1.0 4B,把这个问题做成了可下载、可调节循环次数的模型。它最有意思的地方,是同一份权重能服务不同的计算预算。不过,官方测试也留下了一个值得细看的细节:多循环几次,并非每项成绩都继续上升。
模型内部多走几圈,和把答案写长有什么区别?
想象一位编辑处理一段材料:先形成初稿,再把同一套判断过程用于下一轮修改。Dory 的循环可以借这个比喻理解,但真实发生的是网络内部数值状态的更新,并不是模型每轮都写出一段自我反省的文字。
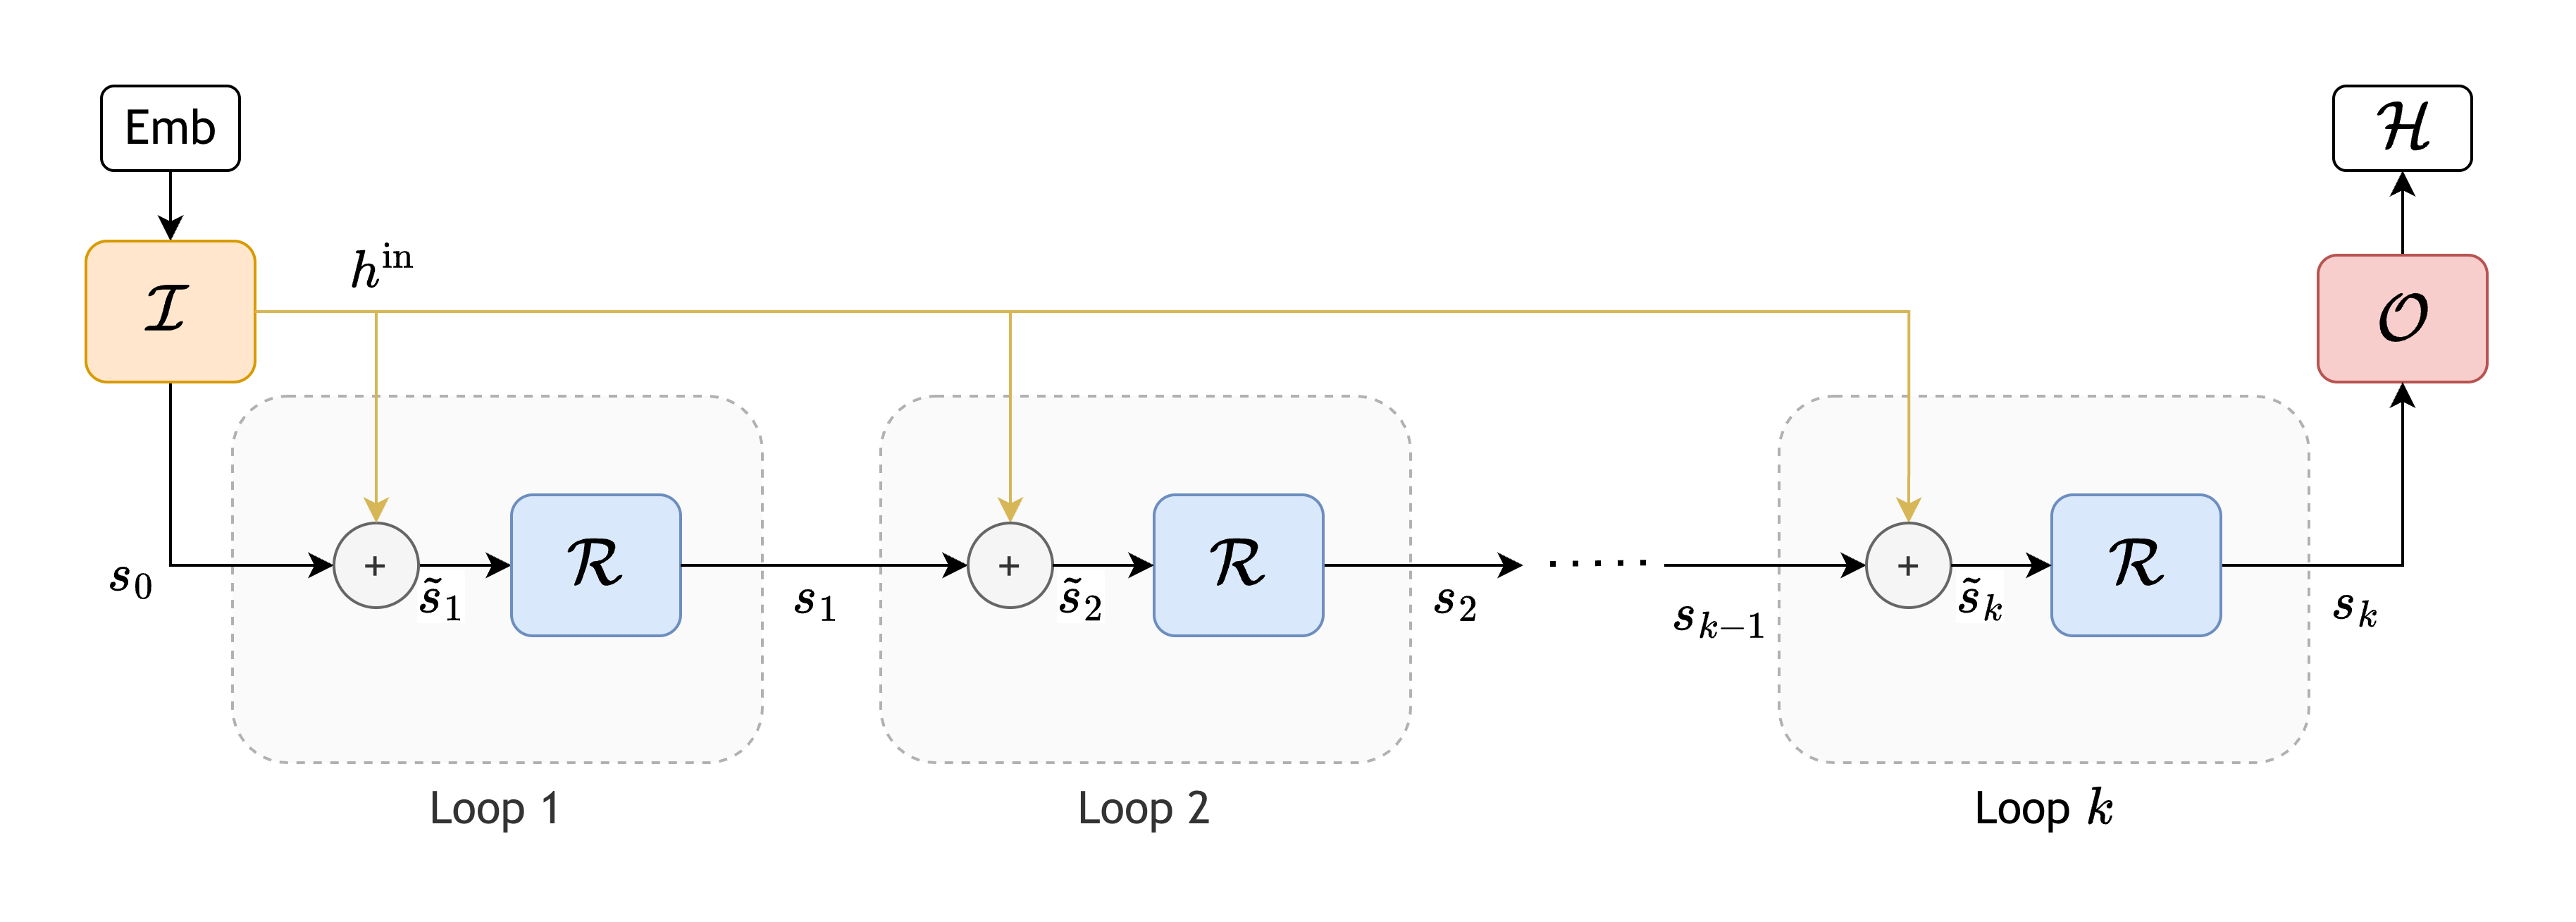
图:NVIDIA 模型卡中的原始架构示意。I 为输入模块,R 为重复使用的循环模块,O 为输出模块;黄色连线表示每轮重新注入输入信息。核查于 2026 年 10 月 19 日。来源
图里反复出现的 R 共享同一组参数。因此,循环从一次增加到四次,增加的是执行这部分网络的次数,不是把模型权重复制成四份。官方配置文件把默认循环次数设为 2;“40 亿参数”与“每个 token 要经过多少计算”,由此成为两个需要分开看的维度。
这条研究路线有前史。Jonas Geiping 等人在 2025 年的循环深度论文中,已经研究通过反复执行网络模块,在隐藏状态里增加推理计算,与主要靠生成更多文字增加计算量的方式作对照。那篇论文研究的是另一套概念验证模型,不能把其中成绩直接移到 Dory 身上。
Dory 还采用了 normalized-GPT 作为骨干。早在 2024 年的 nGPT 论文中,研究者就讨论过对网络向量进行归一化的设计。它与循环深度是不同层面的技术:前者涉及网络如何表示和处理信息,后者决定同一部分网络执行几次。不能把旧论文里的训练提速数字,当成这次模型的推理提速承诺。
这次发布的新闻价值,在于把这些设计放进一款开放权重的小模型,让使用者可以直接比较计算预算变化后的表现,而不只是阅读一种架构设想。
一张表,就能看出循环次数的边界
下面选取 NVIDIA 官方模型卡里的三项 BF16 测试结果:
| 测试项目 | 1 次循环 | 2 次循环 | 4 次循环 |
|---|---|---|---|
| SWE-bench Verified | 50.3 | 59.5 | 61.8 |
| GPQA Diamond,不用工具 | 69.19 | 72.41 | 72.16 |
| HLE,纯文本、不用工具 | 8.25 | 10.89 | 10.43 |
数值沿用厂商原表,由 NVIDIA 在其评测框架下测得,本站没有独立复现;这里不把分数直接换算成真实工作的完成率。
代码修复测试随着循环增加继续改善;另外两项从一次到两次提高,从两次到四次却略降。小幅变化本身不能证明统计上显著变差,但足以说明:这张表不支持“循环越多,每个任务都越强”的结论。
对实际应用,更有意义的比较单位是一整项任务。内部每个 token 算得更多,可能换来更短的输出,也可能降低重试次数;最终耗时能否减少,要把这些环节放在一起测量。只看每秒输出多少 token,或者只看回答长度,都不足以算出收益。官方建议从两次循环开始,也不等于已经替每一种工作负载找到了最优设置。
参数没变,缓存却可能跟着增长
开放权重容易让人联想到本地运行,但循环模型还有一笔缓存开销。生成文本时,模型会保留之前内容的部分计算结果,通常称作 KV 缓存,方便后续继续计算。
在 Dory 的 vLLM 适配讨论中,开发者明确说明,默认方案为不同循环分别保留缓存。权重虽然共用,缓存仍可能随循环次数增加。另一种 last-loop 方案只保留最后一轮的相关缓存,减轻这部分内存负担,但这不意味着额外计算也消失了。
llama.cpp 的适配说明补充了更具体的限制:last-loop 会改变预测,预填充的分块大小也有影响。因而,“省缓存”应理解为另一种需要比较的运行方式,不能直接写成完全无损、没有代价的优化。
这也解释了为什么开放一个模型和获得成熟的本地使用体验之间,往往还隔着推理软件。用户需要的不只是下载文件,还包括正确处理循环、缓存与精度的运行支持。
现在可以确认什么,哪些还要继续看?
截至 10 月 19 日核查,vLLM 的 Dory 支持请求仍处于开放审核状态,llama.cpp 对应请求仍标为草稿;后者说明 Metal 未完成测试,长上下文验证也尚不完整。模型卡提供的特定运行示例,不能替代这些项目的正式发布支持。本文没有安装模型或测量不同电脑的速度,因此不给出“普通笔记本都能流畅运行”的判断。
模型卡将支持语言列为英语,因此也不能从这组测试直接推断它在中文任务中的表现。
授权方面,Dory 使用的是 OpenMDW 1.1,再分发模型材料需保留许可与适用的来源说明。是否下载和部署,应以这份具体许可及运行项目的实际状态为依据。
相比此前介绍的 Timestral 小型时序模型,Dory 展示了另一种“小”的方向:在同一份权重上,把推理时投入多少计算变成可调选项。这让小模型的讨论多了一项有用的问题——在什么任务上,多算一轮真的值得?
下一步值得等的,是独立复现、稳定运行支持,以及同一硬件上按完整任务计算的时间和资源消耗。现有数据已经表明循环能带来收益,也表明它有边界;把这两面一起留下,才比一句“小模型逆袭”更接近这次发布的实际分量。
评论