Meta 发布 Muse Wonder:记忆与长任务升级,Full 版有哪些限制?
一个 AI 助手知道你的要求,却在做到一半时忘了重点,仍然很难让人放心把完整工作交给它。Meta 在 2026 年 10 月 12 日发布 Muse Wonder 和 Muse Wonder Full,将跨对话记忆与持续完成长任务放到了产品中心。官方研究公告分别把这两项能力称为 Active Memory 与 Active Focus。
这次发布同时涉及模型、开发接口和订阅工具,最容易误解的也恰好是它们的关系:更强的 Full 版,目前并没有与普通版一起进入公开 API;面向个人的 Muse 应用还属于接下来的上线计划。
两个版本,三种入口,先把可用范围分清
截至北京时间 2026 年 10 月 14 日,官方公告、开发文档与模型产品页给出的范围如下:
| 入口 | 当前公布的范围 | 需要注意的条件 |
|---|---|---|
| Meta Model API | Muse Wonder,模型 ID 为 muse-wonder-1.0 |
文档标为预览;Full 未提供这个接口入口 |
| Muse Code | Muse Wonder;指定订阅计划还包含 Muse Wonder Full | Full 产品页列出 Power Usage、Maximum Usage 计划 |
| 面向个人的 Muse 应用 | Wonder 将随后接入 | 官方称会先向订阅用户推出,不能写成所有用户已经获得 |
普通版 API 的标准价格是每百万 token:输入 4 美元、缓存输入 0.20 美元、输出 20 美元。Full 通过 Muse Code 订阅提供,因此不能把普通版的单价直接填进 Full 的成本对比。
这里还有一个与隐私有关的选择。价格文档说明,API 的 Standard 模式不使用内容训练 Meta 模型;API 的 Contributor 折扣模式目前针对指定 Spark 版本,Wonder 不支持该模式。而 Muse Code 的订阅默认采用 Contributor 模式,可以在设置中切换。准备交给智能体的如果是项目代码或内部资料,这个区别比“接入同一家公司”更具体。
“记得住”与“坚持做”解决的是不同问题
按 Meta 的解释,Active Memory 希望在跨对话时保留重要信息,并在相关任务中取回;Active Focus 则强调任务受阻后尝试别的路径、适应新信息,以及在必要时澄清或确认重要行动。这些是厂商对能力的描述,本站没有独立运行测试。
可以用一个假设场景理解:你上周说活动预算有限,这周要求助手设计报名网站。记忆能力应当帮助它把预算限制带回来;持续执行能力则应帮助它在页面、数据收集和测试之间推进。若你后来明确提高预算,它还需要识别更新,避免执着于旧要求。
所以,好的记忆不只是保存更多内容,还要处理“哪些已经过期”。官方模型卡中的 MemoryBench 包含长对话、干扰信息,以及与原事实冲突或后来更新的内容。这是有针对性的评估设计,但它是内部基准,不能直接等同于每位用户在长期使用中的体验。
长任务也有产品与模型两层条件。Muse Code 文档说明,工具带有审批机制和操作系统沙箱;部分工作流功能受安装版本和上线范围影响。模型能处理复杂任务,并不自动意味着某个客户端已开放所有协作功能,更不能由此推断它能在没有权限时执行外部操作。
能力有进步,但“知道所有事”仍是另一项考验
独立评测机构 Artificial Analysis在 10 月 12 日报告中给出:最大推理强度下,Wonder 与 Full 的 Intelligence Index v4.3 分别为 52、56,较 Spark 1.3 的 48 提高。这个结果支持新系列整体能力前进了一步。
同一份报告也保留了知识方面的弱项。下面这张图衡量的是知识回答的可靠性:正确回答得分,错误回答受到惩罚,拒绝回答不会受到同样的处罚。Wonder 和 Full 在图中的分数分别为 25、30,这两个数字不是答题准确率。
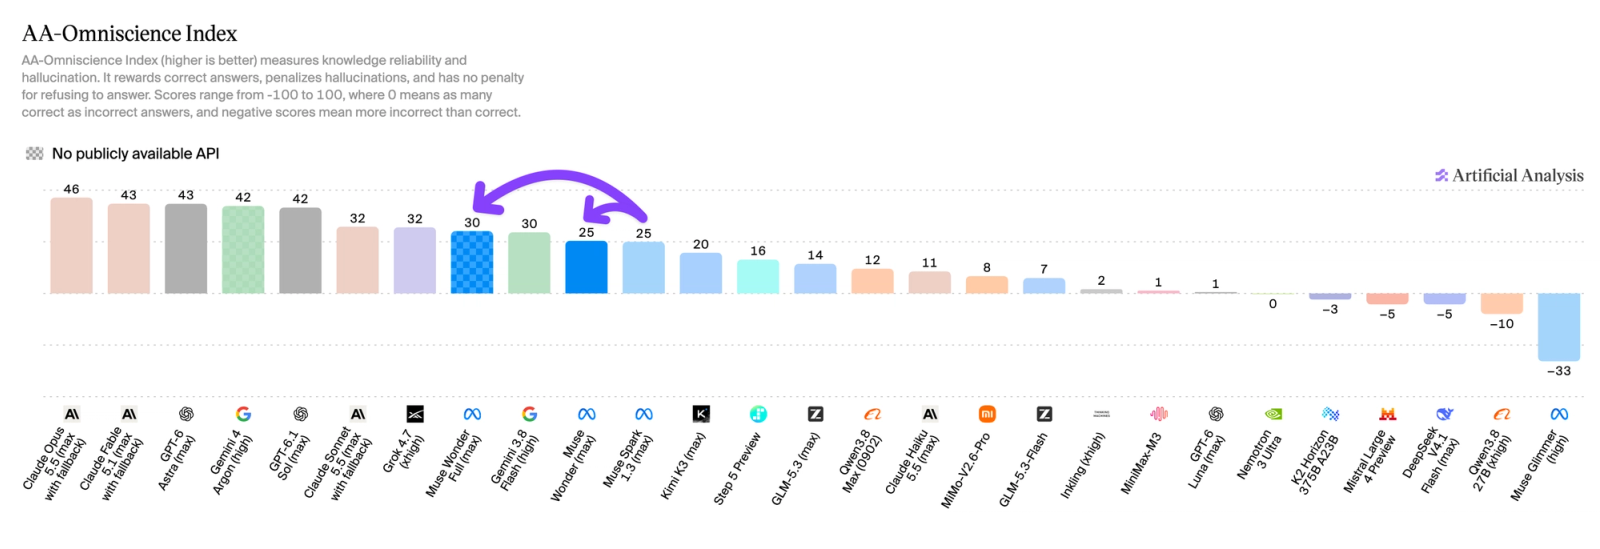
图:Artificial Analysis 于 2026 年 10 月 12 日发布的评测原图,来源为该机构的 Muse Wonder 报告,核查于北京时间 10 月 14 日。条件与指标以原报告为准,本站没有复测。
把整体能力与知识可靠性分开看很有价值。助手可能更擅长组织工作、调用工具、修复代码,但遇到需要准确出处的资料,仍然应检查它是否真的找到了原文。不能把一个综合分数变成“所有领域都领先”的结论。
成本也需要按任务理解。Artificial Analysis 在其 Intelligence Index 工作负载中测得 Wonder 平均每任务 4.52 美元,Spark 1.3 为 1.60 美元。那是指定评测的平均结果,不是每次聊天或每个项目的报价。复杂任务会多次读取上下文和调用模型,输出字数更少,账单也未必更低。
这次发布改变了竞争方向
本文的判断是,Meta 正在把竞争从“回答好一条问题”,推进到“带着上下文完成一项工作”。对于用户,可观察的标准也随之变得具体:要求变更后能否纠正记忆,受阻时能否说明问题,最终结果是否符合约束,以及重要行动有没有等待适当确认。
模型卡明确承认,多步骤推理仍会出错,测试无法覆盖所有场景;其超级智能扩展框架说明了风险评估与防护的流程。公开这些资料有助于审视产品,但不能把政策承诺当成每一次操作都会安全的保证。
本站此前梳理的 Gemini 企业智能体侧重企业身份与权限。Wonder 的记忆和专注侧重任务连续性。这两条路线都在走向更长的实际工作流程,也都需要把能力、工具和授权放在一起评价。
查阅 Meta 开发资料和海外评测页面时,如需比较网络服务,可参考站内的网络服务整理;连接条件不会改变模型的订阅资格、平台支持范围或数据使用设置。
本文除主公告外,实际查阅了模型卡、开发入口说明、API 价格与数据模式、Muse Code 文档、Artificial Analysis 独立评测及安全框架。原链接已随相关事实标注;资料核查截至北京时间 2026 年 10 月 14 日。
评论