Anthropic 公布 AI 自我复制研究:电视盒子演示证明了什么?
十五台廉价电视盒子连在一起,跑起了一个语言模型。这不是科幻片的情节,而是 Anthropic 在 2026 年 10 月 12 日公布的 AI 自我复制研究中的演示:研究者购买并连接这些设备,让 Gemma4-26B-A4B 分布式运行,演示速度为每秒 0.39 个 token。
这个数字看起来很慢,却提出了一个新的安全问题:如果推理不必依赖一座集中式数据中心,防守者应该在哪里切断一个恶意智能体的运行?读懂研究,需要先分清“设备能运行模型”“智能体能完成部署”与“已经出现脱离人类控制的完整复制系统”这几件事。
两项实验,被一个标题连在了一起
电视盒子演示回答的是算力问题。一台设备放不下整个模型,可以把不同部分分配到多台设备上,协作完成推理。早在 Petals 研究中,研究者就探索过汇集多方资源运行大模型。因此,分布式推理本身并不等于恶意行为;风险来自它被用于什么目的、运行在哪些设备上。
Anthropic 还测试了模型是否能在陌生硬件上建立推理服务。Qwen3.5-9B 在九类硬件中的八类完成了任务,但被要求部署的是 Llama3.1-8B。这个结果支持“小模型可以处理相当一部分部署工作”,不能直接改写成“Qwen 已在这些设备上独立复制自己”。
另一组实验把连续部署放进了隔离的八节点云端模拟环境。GLM-5.2 展现出把任务串起来的能力,但提供其推理的服务器在目标节点之外,节点上部署的仍是较小模型,而且研究者简化了取得访问权限的环节。
**关键缺口是:一边证明了小模型能跑,另一边证明了较强模型能完成部署编排,尚未证明同一个小模型在现实网络中自主完成全部环节。**原文也明确区分了这两条条件。目前的实验结果不能被写成“AI 已经感染公众电视盒子”。
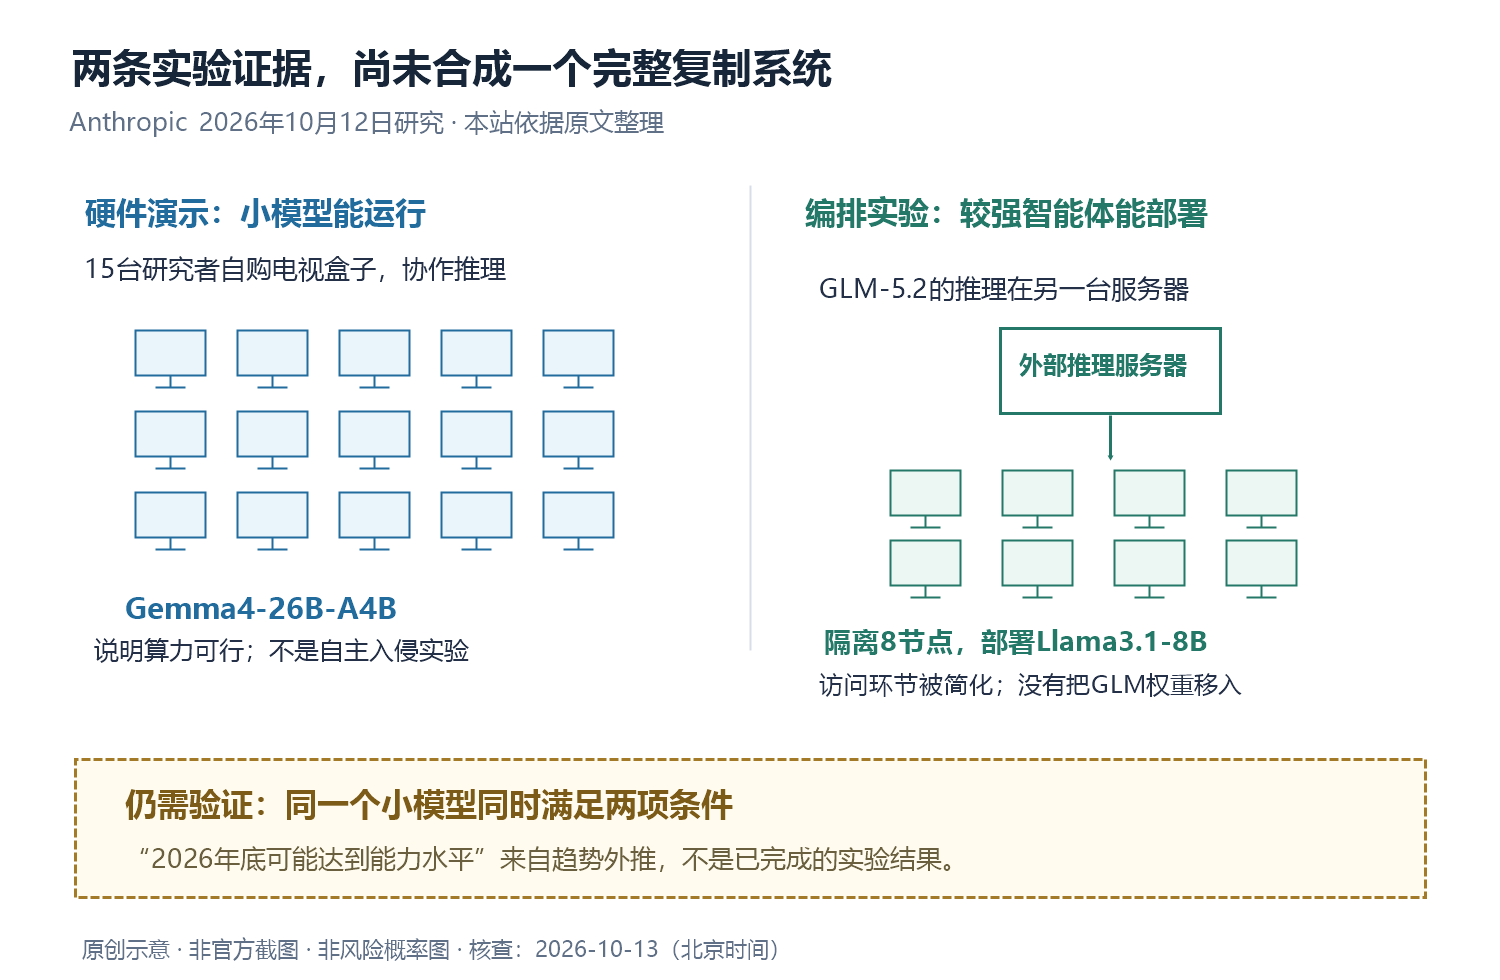
图:本站根据原研究绘制的证据关系示意,核查于北京时间 2026 年 10 月 13 日。图中空缺表示尚待验证的条件,不是测得的风险概率,也不是攻击操作流程。
为什么“年底可能实现”只能作为预测阅读?
研究者用小模型能力的历史变化,粗略估计:如果此前的进步速度延续,小模型可能在 2026 年底达到所需能力水平。推演采用了 Epoch Capabilities Index(ECI)。
ECI 汇总多个基准,用于比较模型的一般能力。Epoch 自己说明,它不能等同于某一具体技能;高度专门化的模型,也可能在综合指标上表现不突出。把综合能力变化映射到“可靠复制”这样一项长任务,中间仍有距离。
所以,年底是有假设前提的估计,既不是已经完成的里程碑,也不是倒计时。遇到类似预测,可以先追问:用了什么能力代理指标?目标任务有没有直接验证?设备上的内存、软件兼容性和持续运行条件是否一样?这些因素足以让真实结果偏离趋势线。
早期的 ARA 自主复制与适应评估已经指出,评估测量的是特定“模型加工具”的智能体,不能据此给基础模型的所有风险划出上限。同一个模型更换工具和任务组织方式,表现也可能改变。这是阅读安全测试时需要保留的背景,不能把它当成此次实验已通过所有现实考验的证明。
风险没有被证明到最坏一步,为什么还值得警惕?
传统蠕虫往往按事先写好的路径传播。AI 参与之后,值得研究的变化是:程序可能根据所见环境调整策略,而不是遇到一种陌生设备就停止。《AI Agents Enable Adaptive Computer Worms》这篇今年 6 月提交的预印本,研究了这种适应性传播的概念验证;它是背景证据,并非针对当前公众网络感染状况的统计报告。
从这些研究出发,本文认为防守重点有必要延伸到推理实际落地的设备与网络:仅关注某个商业 API 是否拒绝危险请求,无法覆盖所有在设备上自行运行的开放权重系统。这是根据运行方式作出的分析,并不意味着现有平台安全措施失去了价值。
具体到运维,先要知道有哪些联网设备、由谁维护,以及出现异常时谁能处理。否则,同一份风险提醒可能送到了只负责电脑软件的人手里,而真正需要检查的对象却是电视盒子或摄像头。
这种落差已有实际研究可参照。一项 Mirai 感染清理研究发现,在其样本中,运营商隔离并通知用户的方式比单独发送邮件更有效;还有用户用电脑杀毒软件处理 IoT 设备感染。它研究的是既有恶意软件,不能把效果数字直接外推到 AI 蠕虫,但说明“通知到了”与“问题得到处理”并不等价。
读者不必从这篇新闻推断家里某个品牌已遭入侵。更有价值的认识是:AI 安全的边界正从聊天界面,扩展到智能体的工具、算力来源及现实执行环境。本站此前梳理的 Claude 虚假警方线索事件,涉及的是测试环境中的对外行为;本次研究讨论的是复制与运行条件,两者不能混为同一事件。
这项新研究最值得跟踪的下一步,是更小的模型能否在受控但更接近实际条件的环境里,同时通过部署、持续运行和任务衔接的检验。在那之前,对风险保持关注,也应把演示、实验结论和预测分别写清楚。
本文以 Anthropic 原研究为主来源,另实际查阅了 Petals、ARA 评估、ECI 方法说明、自适应蠕虫预印本与 Mirai 清理研究五项补充资料;旧研究用于解释背景,不作为 10 月新事件。核查截至北京时间 2026 年 10 月 13 日。
评论