NVIDIA 发布 Nemotron 3.5 Bolt E4B,聚焦简短对话与多轮行动
对游戏角色或语音助手来说,一句及时、合适的回应,加上正确完成一次操作,就可能是很好的体验。NVIDIA 在 10 月 23 日发布的 Nemotron 3.5 Bolt E4B 4GB,正是围绕这种即时交互设计的小语言模型。
它的重点是自然对话、多轮工具调用和对应用状态的理解,面向本地设备助手、游戏角色及嵌入式接口。与大模型的复杂研究任务相比,这些场景对等待时间、回答长度和内存余量有不同要求。模型必须知道何时说话,何时调用工具,以及什么时候应该先问清楚。
把“少说几句”做成一种能力
Bolt E4B 经 NVIDIA 后训练,基于 Google 的 Gemma 4 E4B。Google 的基础模型说明解释,E 指有效参数,总参数还包括较大的词嵌入部分,因此 E4B 不能简单理解成总共只有 40 亿参数。
NVIDIA 的具体 GGUF 模型卡提供了对话模式和可开关的推理控制:面向自然交谈时鼓励简短、适合朗读的回答,复杂请求则可以采用推理,并设置运行时的思考预算。
这类控制很实际。假设用户让设备助手调暗灯光,合适的工作流可能是确认目标、调用正确设备接口,再简短报告结果。若用户说的是“把那边调暗一点”,系统又需要结合设备状态或先澄清对象。这是理解应用需求的假设例子,并不是本文运行模型得到的结果。
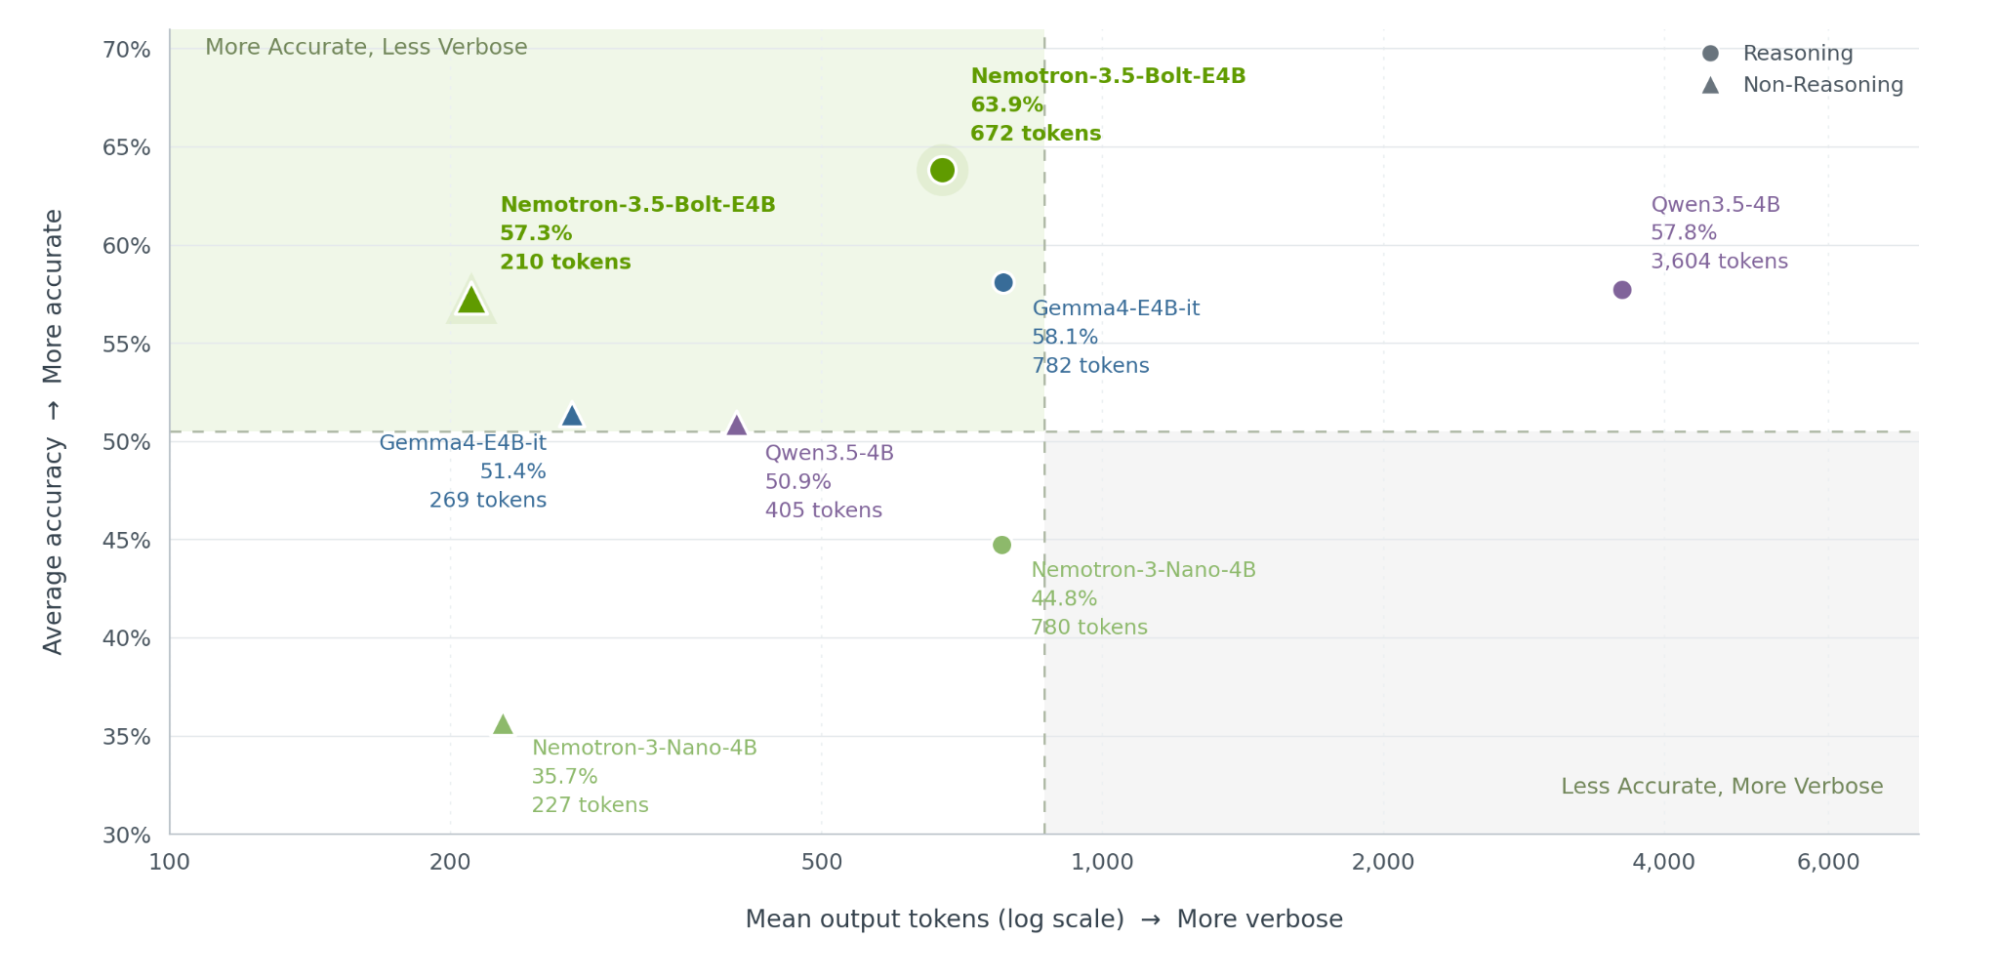
来源:NVIDIA 10 月 23 日技术原文,2026 年 10 月 26 日核查。横轴为平均输出词元,采用对数刻度;圆点与三角形分别表示推理、非推理。图中成绩只描述厂商这组测试。
公开评测展示了缩短输出与保持任务表现之间的取舍,但不能把它改写成所有问题都应回答越短越好。某些工具调用或客服任务中,对照模型仍有更高分;平均提升不表示每一项能力都领先。对用户来说,少生成无用内容的价值,最终应体现在等待更少、操作正确、必要说明没有被省掉。
从一段对话,到完整的设备体验
NVIDIA 这份 GGUF 模型卡把输入和输出列为文字。基础 Gemma 模型家族有图像、音频等能力,也不意味着本次发布的这个检查点自动继承了相同接口。
官方展示的 Reachy Mini 机器人演示,就使用 Cosmos 3 Edge 提供视觉理解,再由 Bolt E4B 组织对话、调用动画脚本。这是多个组件协作的系统,不能把机器人看到世界、做出动作和说话的全部能力都算成单个语言模型本身的功能。
NVIDIA In-Game Inferencing SDK 文档同样把语音识别、语音合成与语言模型列作不同类型的插件,并提供多种推理后端。开发者还要把游戏或设备的状态、可调用的工具,以及相应权限接入系统;生成一个工具调用,并不代表真实世界中的动作已经完成。
这里也能看出它与此前 NVIDIA Dory 4B 循环推理模型的关注点不同。Bolt E4B 更强调即时交互中的对话与行动衔接,而模型研究里增加计算以处理难题,是另一个优化方向。
名称与资源预算。
NVIDIA 在 10 月 15 日的系列公告中已列出较大的 Bolt 74B-A9B 24GB,并预告 E4B 于 23 日交付。如今的新发布是后者,两者不能只看共同的 Bolt 名称就混为一谈。
4GB 是特定目标负载下的低内存定位。以 NVIDIA 公布的 Q4_K_M、llama.cpp、单会话测试为例:RTX 5070 在约 3000 输入词元、50 输出词元时,峰值显存为 3.5GB;已有约 32000 词元缓存,再加入 2000 输入、生成 256 输出时,峰值为 4.3GB。上下文、软件和硬件变了,结果也会变。
因此,一张 4GB 显卡并不因为型号名称就获得了任意上下文的运行保证。模型文件体积、运行时显存和整套应用的内存需求也应分别核对,尤其在还要同时运行语音或视觉组件的时候。
Ollama 的 Bolt 模型库目前同时包含 74B 与 E4B 条目,默认模型和带有 E4B 标记的变体不同。比较产品页时,要先确认具体检查点与打包版本;提供方的家族标签不能代替 NVIDIA 这份 GGUF 模型卡的输入输出与部署说明。
从上述组件分工可以推知,首个词元出现的时间只覆盖整条体验的一段。如果系统还要先识别语音、等待工具完成操作,再合成声音,用户的实际等待时间就取决于整条链路。模型首字延迟不能直接当成完整语音助手的开口时间。
在一个假设的游戏交易任务中,角色还需要依据工具返回的库存和付款状态继续回应。若商品已经缺货,流畅地说出成交台词并不能算完成任务。这解释了 NVIDIA 为什么把对话与工具结果的衔接放进评价范围:正确使用环境里的信息,与说得自然,同样影响体验。
这次发布让本地 AI 的竞争多了一种明确的衡量方式:在设备还要运行游戏或其他应用时,能否用可接受的资源,完成自然、连贯的对话和动作。对于这种体验,完成一小件事的整个过程,往往比单看每秒生成多少词元更接近用户感受。
资料核查截至 2026 年 10 月 26 日。性能数据均为厂商披露,本文未独立进行模型或设备测试。
评论