Google 发布 Gemini 4 Carbon,先向网络防御者开放
10 月 28 日,Google 公布 Gemini 4 Carbon,把升级重点放在持续执行的复杂工程任务,以及漏洞研究和修补等网络防御工作上。它接在 Argon 之后亮相,但开放节奏有自己的安排:发布公告称,本周先向部分网络防御者提供,再经 Fairwind Program 扩大到更多可信伙伴,日常开发者、企业和消费者产品仍写着“即将到来”。
因此,看到新模型名称和价格,并不能判断自己的 Gemini 订阅已经包含 Carbon。截至本文 10 月 30 日核查时,Google 尚未在这份公告中给出面向所有普通用户的统一开放日期。
这次发布值得关注的地方,是 AI 工程能力越来越多地围绕“把一个复杂问题追到底”来展示。Google 表示,其内部团队观察到 Carbon 可以在跨代码库、低层系统的任务里持续探索和修复;这是厂商的观察,本文没有独立实测。
三类安全成绩,各自测的是什么
Google 公布的数字包括 SEC-bench Pro 的 88.2%、ExploitGym 的 54.8%,以及 CWE-bench 的 71.0%。它们分别关联漏洞研究、利用验证和审计修补,不能加成一个“整体安全率”。
先看最醒目的 88.2%。SEC-bench Pro 原始项目把真实历史漏洞报告、复现材料和可重复运行的环境整理成评测任务,覆盖浏览器引擎与 Linux 内核等软件。但 Google 的 Carbon 评测说明明确:这个分数采用的是 2026 年 5 月的 183 项 JavaScript 引擎任务分组,由其自行评测。
这与“能找出任意软件中 88.2% 的未知漏洞”相距很远。读者需要先知道题目来自哪里、怎样判分,再看百分比;不能把一个分组的成绩扩大成整个开源软件世界的能力。
ExploitGym则侧重验证 AI 智能体能否把真实漏洞转化为有效利用,材料涉及用户态程序、V8 和内核等场景。对于防御团队,验证风险能否实际成立,有助于判断修复优先级;但实验环境中的表现,仍受工具、运行时间和系统配置影响,不能直接当成公网攻击结果。
Google 在发布文中说明,这组外部网络安全基准是在关闭防护措施的条件下评估的。这里展示的是特定条件下的能力,不是普通用户产品会原样放行所有操作的承诺,也不能据此推断上线产品绝对安全。
修补能力更接近日常维护工作。Collinear 的 CWE-bench使用 120 项保留评测任务,让智能体审计并修复代码。它既检查漏洞是否被阻断,也检查既有功能是否仍然工作。
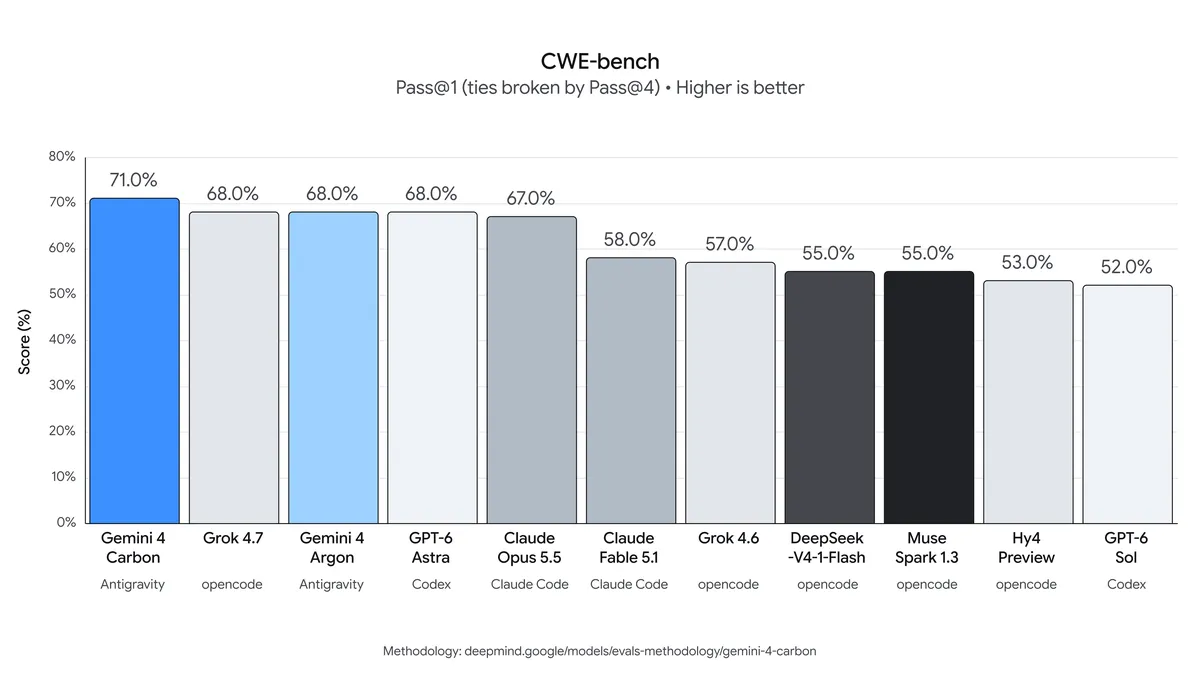
图源:Google 10 月 28 日 Carbon 公告,核查于 10 月 30 日。图中使用 pass@1 口径,不能与多次尝试口径混用;成绩和工具配置须结合原始榜单及评测说明阅读,本文未复测。
在该榜单的程序判定口径下,Carbon 是 71%,Argon 是 68%,相差 3 个百分点。CWE-bench 还列出多次尝试的结果,说明允许反复尝试会改变评价方式。对维护者来说,“改出来一份补丁”和“补丁解决根因、原有功能也没坏”,才是更值得区分的两件事。
图中还标出了 Antigravity、Codex、Claude Code 等运行工具。智能体成绩来自模型与工具的组合;可用工具、上下文和运行预算都会影响结果。Google 的方法说明也注明,部分对手成绩取自其厂商报告,不能把整张比较图理解成所有项目都由同一方重新实测。
开放范围,要与价格一起看
Fairwind Program面向经审核的防御组织,优先考虑政府、关键基础设施和核心技术平台等。项目设有组织审核和访问管理要求,属于特定合作通道。
核查时,该项目的常设页面仍主要介绍 Argon。Carbon 的新增开放安排,应按此次发布公告理解,不能把旧型号说明或一般付费套餐直接视为 Carbon 资格。
Google 同时公布了 Carbon 的未来入门促销价:每百万输入 token 2 美元、输出 token 10 美元;脚注写明,促销结束后分别为 4 美元和 20 美元。这份公告没有给出促销结束的具体日期,也不应把其他型号的优惠期限套过来。
这些价格可以用于理解其产品定位,但估算实际任务费用,还需要知道最终计费规则、输入输出长度和重试次数。一个任务运行更久,可能换来更完整的排查,也可能消耗更多预算;“能持续工作”本身并不是省钱的证明。
本站此前梳理过 Gemini 4 Argon 的开放与 API 价格。对已经使用 Argon 的读者,接下来值得跟进的是 Carbon 会进入哪些产品、谁能选到它,以及权限和费用如何落地。
长任务升级,也要看交付质量
假设一个团队需要修复横跨多个模块的缺陷,理想结果不只是生成一段代码,还包括定位原因、修改相关调用、检查回归并解释剩余问题。这个例子用于说明工程任务的构成,不能当作 Carbon 已完成的客户案例。
Carbon 的发布把讨论进一步推向这种完整过程。模型如果能减少中途放弃、无依据结论和错误修改,价值会比多生成几行代码更直接。但判断这些提升,需要看具体任务、测试条件和可检查的交付物。
目前可以确认的是:Google 已公布新的能力方向、受限的先行开放安排及价格计划。普通用户可以继续关注实际产品入口和明确的使用条件,再结合真实任务判断升级价值。
评论