Eleven Realtime 发布:Mini 与 Max 的差别,不只是开口快慢
10 月 20 日,ElevenLabs 发布 Eleven Realtime v1 Mini 和 Max。这个以 AI 声音出名的公司,这次把产品重点放到了整段对话:听懂用户、判断什么时候接话、组织答案,再把话说出来。消息来自其发布公告。
看懂这次发布,可以先想象一个订票助手的场景:你刚说完目的地,又补了一句“等等,改成周五”。一个声音悦耳、回答飞快的助手,如果忽略后半句,照样会把事情办错。这是说明体验差异的假设例子,并非本站实测结果。
实时语音正在竞争的,正是这些容易被“多少毫秒”盖过去的细节。
把整套语音代理交给厂商调配
过去搭建语音助手,开发者往往分别选择语音识别、大语言模型、语音合成,再处理停顿和打断。每个零件都不错,接起来却未必顺畅:用户只是想了一下,助手就抢话;用户已经插话,助手还在继续念答案。
ElevenLabs 的新方案把这组选择收进 Realtime 模式,由厂商统一管理相关配置。根据模型文档,切换后,大语言模型、推理设置、语音合成和识别提供方等选项由系统接管,提示词、声音、工具和知识库等设置仍然保留作用。
这首先是一种产品整合方式。公开说明没有给出足够信息,让外界把它直接认定为一个取代所有环节的原生端到端神经网络。 对读者来说,少调几个参数是否真的换来更可靠的对话,比架构名称更有意义。
Mini 和 Max,没有包揽所有指标的赢家
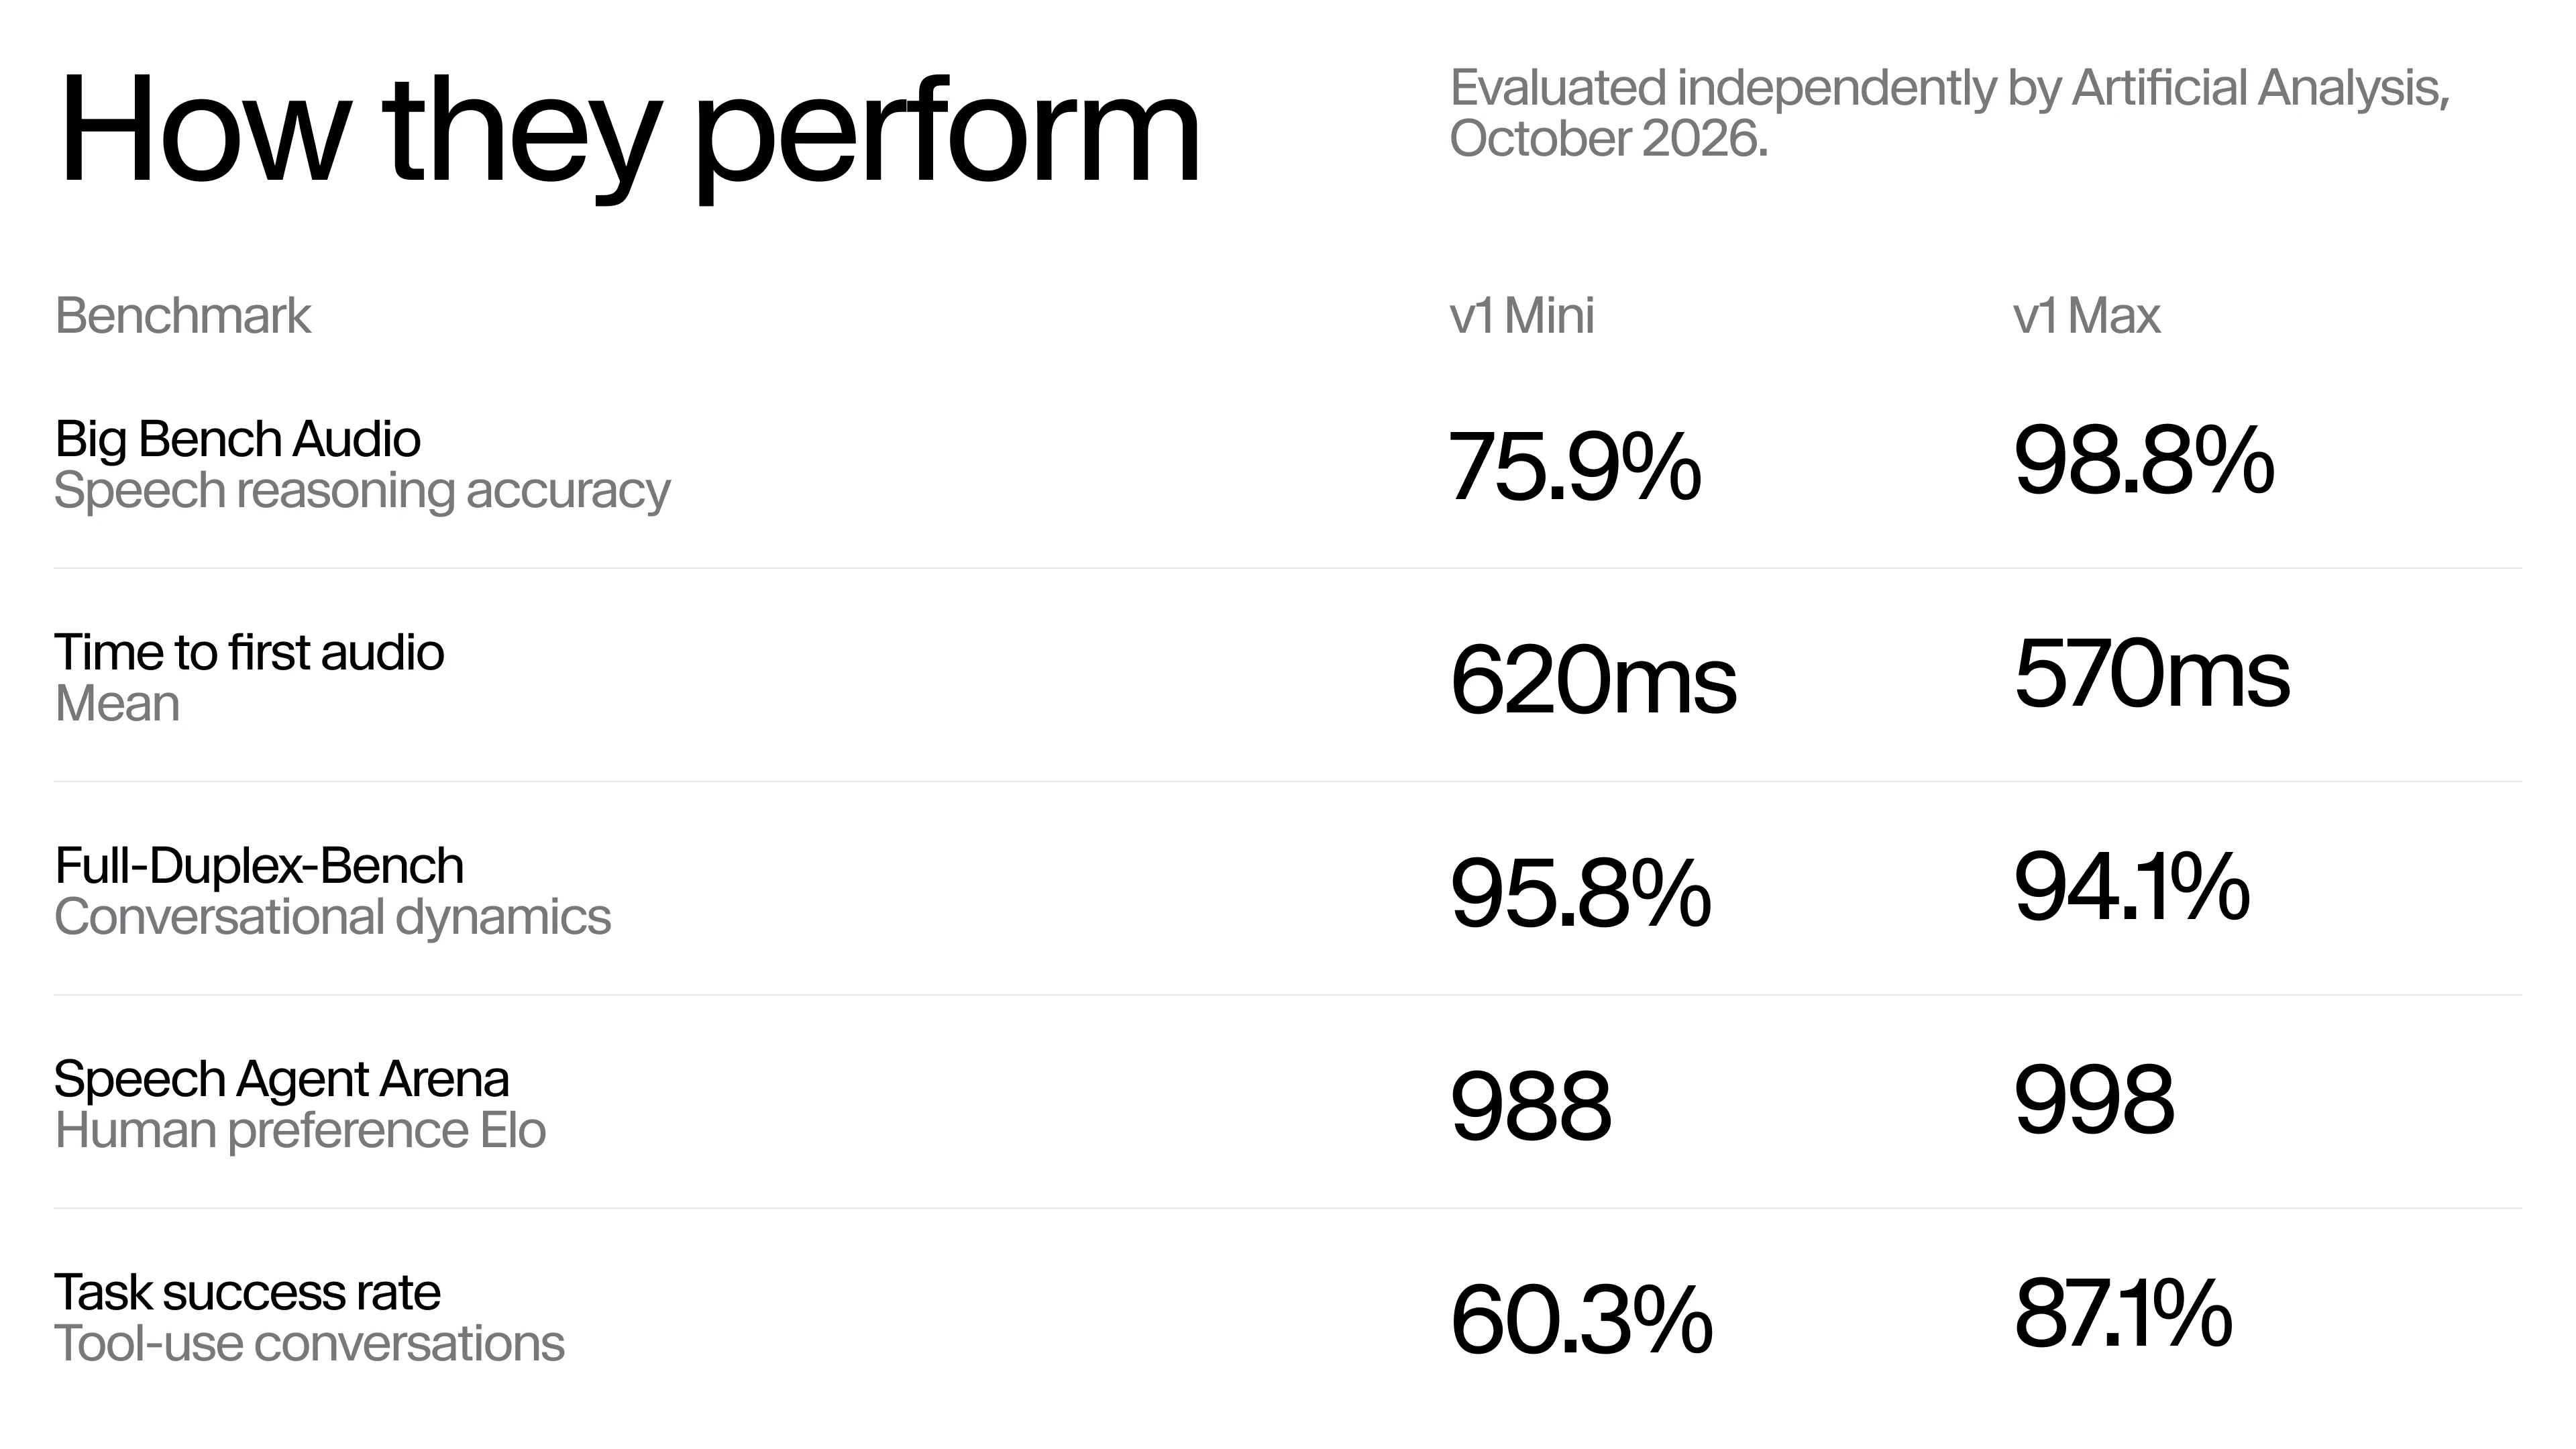
图源:ElevenLabs 10 月 20 日发布公告,表中为其引用的 Artificial Analysis 评测结果;2026 年 10 月 21 日核查。保留发布时快照,实时榜单中的人类偏好评分可能继续变化。
这张表最有意思的地方,是两列成绩并没有整齐地一高一低。Max 在语音推理和涉及工具的任务成功率上领先;Mini 在对话动态指标上反而略高。
Artificial Analysis 的说明把这些能力分开衡量:Big Bench Audio 主要考查听取题目后的推理,对话动态则关注停顿、接话、打断和简短应答,任务成功率检查是否完成所需的最终工具调用。它们回答的是不同问题。
例如,用户说一句“嗯”,助手该继续;用户说“别订了”,助手则应该调整行为。这类区别,也是 Full-Duplex-Bench 原论文关注的交互问题。该论文是既有评测背景,并非本次发布的新研究。
因此,把 Mini 理解为轻量对话方向、Max 理解为复杂指令和多步工具任务方向,比只看名字挑“大杯”更合理。具体能否胜任客服、教学或业务办理,还要看自己的真实任务,而不能把某个测试的成功率直接当成生产环境承诺。
还有一个实际区别:打断说话和撤销业务操作是两回事。在前面的订票假设中,助手听到“改成周五”之后,可能还需要检查上一项操作是否已提交、重新确认日期,再调用工具。对话接得自然,只解决了其中一部分问题;执行顺序和结果确认,仍然影响最终体验。这里的判断针对语音代理的一般设计,不代表新模型已经通过了这些场景的验证。
这也解释了为什么发布时需要同时展示多种测试:一个偏向闲聊的产品,和一个能修改订单的客服,遇到的失败方式并不一样。选型前先写清楚自己不能接受哪类错误,往往比盯着一个总分更有用。
570 毫秒,不是事情已经办完
公告表中的平均首次音频时延,Max 为 570 毫秒,Mini 为 620 毫秒。Max 在这项测试里还稍快一些,所以“Mini”也不意味着每个项目都更快。
首次音频衡量的是开始输出音频的时间,不是整段答案完成,更不是退款、改签等工具任务已经成功。ElevenLabs 的时延说明还区分了模型计算、网络往返和播放器缓冲:用户耳朵真正听到声音,要经过更多环节。
对使用者而言,一句迅速响起的“我帮你查一下”和真正查到正确结果,价值并不相同。对开发者而言,也应分别观察开始响应、执行完成,以及被打断后是否正确改变行动。这些测量不能压缩成一个宣传数字。
发布了,仍有接入边界
新模型正在逐步开放,文档明确提醒:部分工作区还看不到 Realtime 模式。Mini 与 Max 的可用环境也有差别,例如 Max 当前不支持印度和新加坡的数据驻留环境。已有指定模型或复杂工作流的项目,切换前也需要核对兼容限制。
对已有实时语音应用,ElevenLabs 提供了兼容接入说明。它沿用相应的 WebSocket 事件协议,但浏览器音频采集和播放仍有工作要做;这也不代表 ElevenAgents 平台的渠道、知识库和工作流会自动随一次接口切换迁移过去。
成本同样不能只看模型名字。在 ElevenAgents 中,文档列出的计费由标准通话分钟费用和模型输入、缓存输入、输出 token 费用组成,Max 的每 token 价格更高。实际预算需要结合任务长度,不能凭一句“低成本”算出每通电话的账单。
本站此前介绍过 Grok Voice 3 的发布与时延口径。这次 ElevenLabs 的加入又提供了一个观察角度:语音 AI 的竞争正从“声音像不像人”,延伸到“能不能听着人说话,把事情办对”。对这类产品,最有用的体验测试,也应该围绕后者展开。
评论