DeepSeek 开源 Super-agent 原型:从多开窗口,走向持续协作
一个 AI 在修复缺陷,另一个在整理资料,第三个等你回答问题。表面上任务并行了,人却还要在多个窗口间切换,记住谁做到哪一步、哪条消息该转发给谁。AI 能独立工作之后,新的瓶颈可能出在协调它们的人身上。
DeepSeek Harness 团队10月31日公布的 Super-agent 设计,讨论的正是这个问题。11月1日,团队又在 @DeepSeekHarness 的 X 长文中发布英文机器翻译,明确说这是架构思路探讨,并非现有产品功能介绍。
与此同时,dsh-superagent-prototype 仓库公开了 MIT 许可的研究原型。它基于 DeepSeek Harness,面向单个 GitHub 仓库工作,可以接收 GitHub 以及可选飞书渠道的信息,把获准的工作交给独立会话处理,再回到原讨论中交付结果,例如提交一份 Pull Request。
这些安排让“长期在线的 AI 协作者”有了可阅读、可研究的实现,但还不能把它当成已经成熟的 DeepSeek 正式产品,更不能理解为手机聊天应用自动获得了全部新能力。
让负责接话的 AI,和真正干活的 AI 分工
团队设计把系统分成 Router 和 Worker 两层。Router 负责与人沟通、维护跨任务的上下文并分派工作;Worker 则在相互隔离的会话中执行具体任务。这样,用户可以继续提出新需求,而不用等某个长命令执行完才轮到下一句话。
用一个研发协作场景理解会更直观:群聊里提出一个缺陷,修复在后台继续;后来大家到 GitHub 的代码评审里调整要求,相关信息应当接回原任务。用户不需要重新把两个窗口的背景复制一遍。团队文章展示了内部使用方式,这不等于我们已经在自己的项目里复现了同样效果。
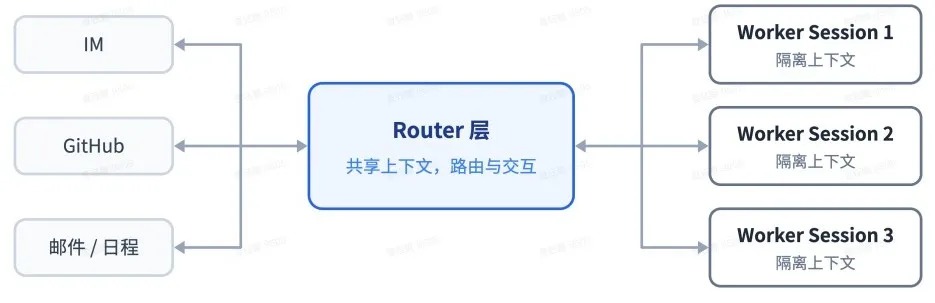
图源:DeepSeek Harness 团队设计示意,见 IT之家10月31日报道,11月2日核查。图中邮件、日程等属于架构讨论中的入口,不代表公开原型已经全部支持。
公开原型的架构文档进一步展示了实际分工:主会话承担研判,执行组件为每个工单提供独立会话与目录,状态另外保存。它关注的是任务如何持续推进、结果如何回到人面前,而不只是同时多开几个对话页。
这种思路的价值,是减少人在多个上下文之间反复搬运信息。代价也存在:多个独立会话会消耗更多计算资源,调度、状态恢复和权限关系也更复杂。是否值得采用,要看它节省的人类协调成本,能否超过系统新增的运行与维护成本。
“主动”有权限前提,观察到消息不等于获得授权
架构文章主张先用程序规则过滤大量无关事件,再让模型处理需要理解语义的候选消息。如果群里的每句闲聊都要交给大模型分析,不仅消耗资源,也容易让一个本应帮忙的系统变成不断插话的机器人。
原型的授权文档把这条边界落得更具体:允许列表、规则与工单授权由宿主系统执行,外部消息、评论和引用文档不能自行改变这些权限。
对于从环境中推断出来的任务,默认 observe 模式只评估并记录“本来会接单”,不会直接开始执行;切换到 auto 后,才可能根据符合条件的规则接单。被允许的人明确交付的请求则是另一条路径,在不同模式下都可以工作。这里区分的是授权依据,不是让模型只凭“看起来有用”就替团队做决定。
项目理念文档也把减少打扰作为目标:需要人做决定、出现可用结果或无法完成时再发言,不以制造大量 PR 和广播消息证明自己很忙。这一点很贴近真实工作。一个全天在线、每天却给团队增加几十条无关提醒的 Agent,未必比安静做好一项任务更有价值。
研究原型回答了什么,还没有回答什么
团队长文中的初步实验,使用约300条合成消息,其中约20条是工作请求;编程工作由消耗时间的模拟工具代替,每种方案运行5次。Super-agent 的任务完成时间 p95 为15.7分钟,中性提示的单会话方案为29.5分钟。这组结果评估的是调度与协调,不是它真实修复代码的准确率,也不是与 Claude Code 的通用能力排名。
README还明确提醒:公开版本为发布做过适配,与内部实例和设计文章所述实现不完全一致,文章里的部分方向尚未实现。因而,架构中讨论到的长期在线、跨设备与监控恢复机制,都不能不经核对便列成开源原型已经完整交付的功能表。
原型走向日常使用,还要经过工程验证
还需要区分底座与插件:DeepSeek Harness 主项目本身仍处于开发者预览阶段,提醒开发者接口可能发生不兼容变化。Super-agent 又是基于它探索协作路线的研究原型,二者不能合并理解成一个已经稳定交付的功能包。
社区反馈也反映出原型阶段需要解决的工程细节。11月1日,一名开发者在 GitHub 讨论区提交了重试授权、停止准备任务和失败后恢复等问题的复现报告,并说明自己的测试并非真实模型与 GitHub、飞书的全链路验证。它值得跟踪,但作者的报告不等于维护者已确认所有结论,提出的补丁也不等于已经合并。
这条新闻的意义,在于 DeepSeek 把一部分 Agent 竞争从“单次回答或任务有多强”,推进到“如何组织持续发生的工作”。站内此前介绍的DeepInfer 推理引擎解决模型运行基础设施问题,Super-agent 讨论的则是协作系统,两者处在不同层面。
下一步判断这条路线是否走得通,需要看真实任务中的长期稳定性、人工接管是否顺畅,以及团队是否真的少花时间盯进度。开源原型让这些问题有了研究起点;可靠的日常协作者,仍要靠后续实现与使用结果来证明。
评论