DeepInfer 开源:DeepSeek 把模型背后的推理引擎交给社区
模型开放了权重,为什么别人照着部署,运行成本和响应速度仍可能不一样?DeepSeek 这次公开的软件,展示了答案的一部分。
10 月 20 日,DeepSeek 开源大规模推理框架 DeepInfer。项目仓库提供离线推理能力,目前支持 DeepSeek-V4.1-Flash;The Next Web 当天的报道也确认了发布时间与 Apache 2.0 许可。
“推理”就是让训练好的模型实际处理请求、生成答案。模型决定它大致会做什么,推理系统则影响这些能力能否以可接受的成本和等待时间交到大量用户手里。这里的新闻价值,已经超出了又一份模型权重。结合站内介绍过的 DeepSeek V4.1 Flash 1017 更新,可以把这次发布看成从模型能力走向运行系统的另一块拼图。
已经公开的,是引擎及其运行方法
DeepInfer 把优化后的计算核心、并行处理、推测式解码、异步调度和结构化输出等能力放到了同一个框架里。官方当前列出的硬件是 NVIDIA SM100 GPU 与华为昇腾 950 NPU,运行环境面向 Linux。
这是一套需要相应基础设施的工程项目,不能从“开源”二字直接推导出普通笔记本一键复刻官方服务。它也没有通过一次框架发布,让模型本身突然获得新的知识或推理能力。
可以把模型、推理引擎和在线服务理解为不同层次:模型负责计算内容,引擎组织计算怎样进行;面对大量用户的服务,还要处理请求分配、缓存复用、容量和故障等问题。这个类比只用于说明分工,不代表各部分能够简单拆开、互不影响。
架构图里,还有本次没有完整交付的部分
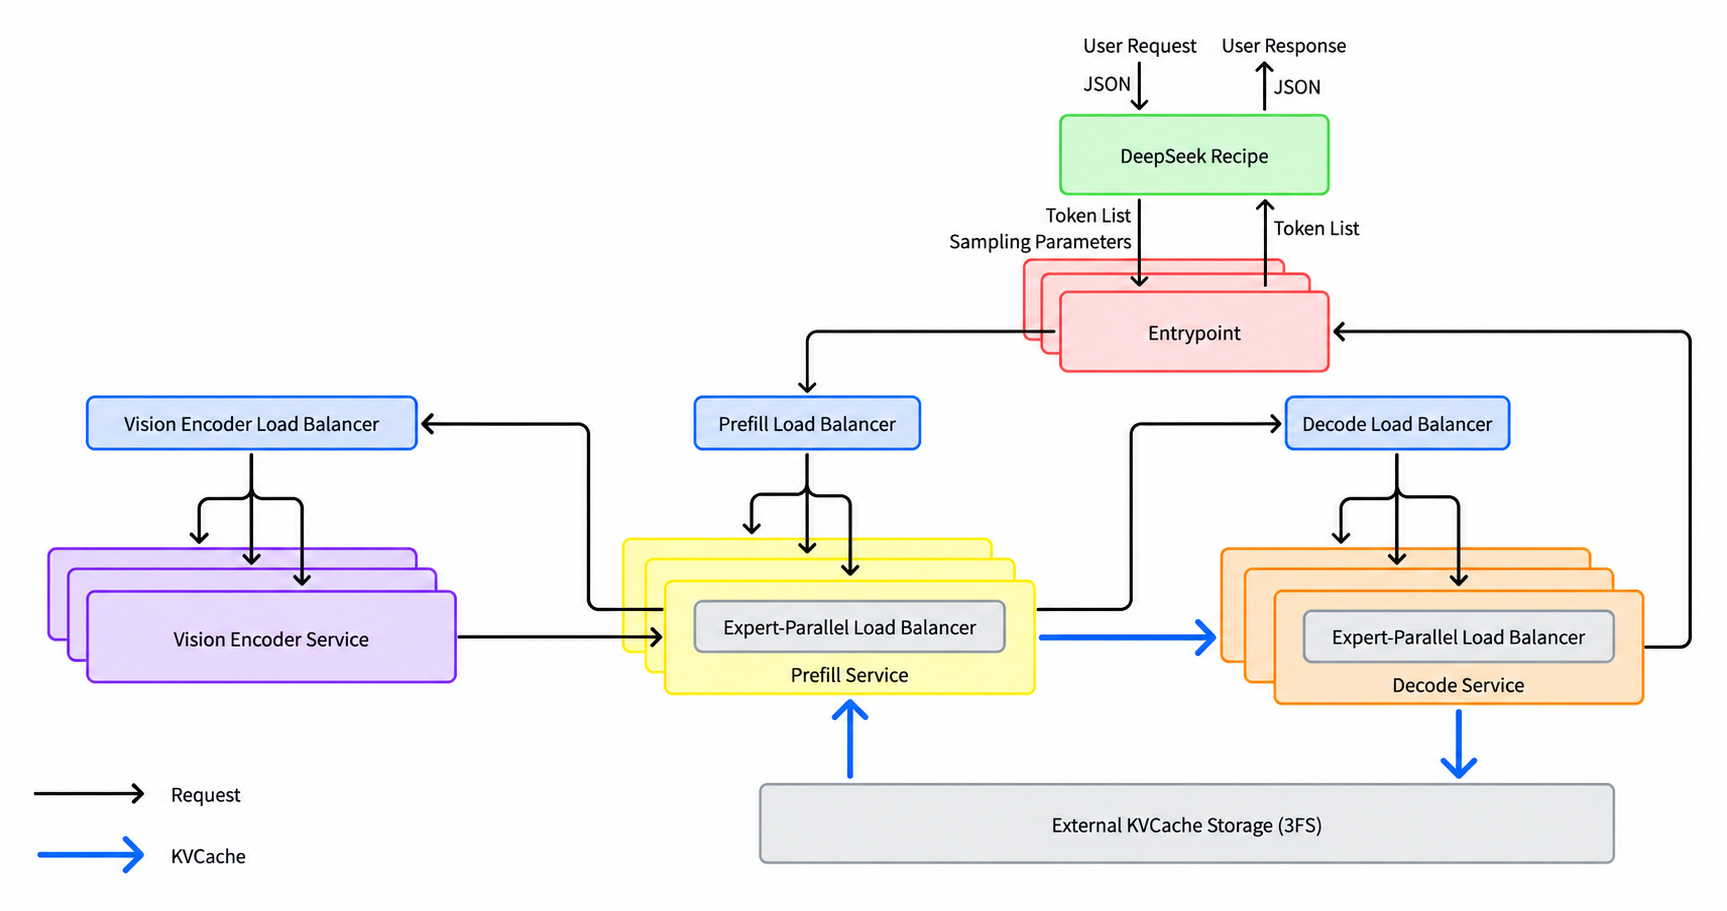
图源:DeepInfer 官方部署问答,2026 年 10 月 23 日核查。此图描述生产系统的整体设计,包含本次开源版本尚未完整提供的组件,不能把整张图当成已交付清单。
README 明确列出,完整服务还需要 KV 缓存系统、图像编码与预填充及解码的分离部署,以及预填充和解码数据并行副本之间的负载均衡。部分引擎底层能力已有实现,但这些环节没有作为一套完整在线服务包含在本次发布里。
其中,缺少的负载均衡有特定范围:它指多份服务副本之间怎样分配请求。引擎内部用于专家并行的负载均衡,已经列在公开功能中,不能简单写成“所有负载均衡都没开源”。
官方部署问答解释,缓存管理与部分调度组件和内部基础设施耦合较紧。这个区别会直接影响外部团队的工作量:拿到引擎之后,要补齐的不是一个漂亮的聊天页面,而是怎样持续、高效地运行它。
KV 缓存可以通俗理解为模型计算过程中的中间结果,并不等同于保存聊天文字。vLLM 早期介绍 PagedAttention 的文章就说明,缓存如何占用和共享内存,会影响同一硬件上能够处理多少请求。那是 2023 年的既有技术背景,文中的速度倍数不应移用为 DeepInfer 的成绩。
同时公开的 Recipe,负责另一段连接
配套项目 deepseek-recipe处理不同接口格式与模型输入输出之间的转换,包括组织提示、编码 token,以及解析模型返回内容。
这件事看上去没有大模型发布抢眼,却关系到外部部署能否正确理解请求:工具调用、思考内容、结构化回答,都需要被准确传入和还原。
它的说明也写得很清楚,调用方仍要提供模型推理、工具执行和 HTTP 传输。换句话说,这个转换组件补上的是一段连接,而不是连服务器、模型和业务操作都包办的完整产品。对于开发者,开放这些细节的意义,是减少“同一个模型为什么在不同服务里表现不一致”时需要猜测的环节。
速度之外,还要看运行条件与答案质量
仓库给出的性能测试条件,是预填充使用 4 张 SM100 GPU,解码使用 64 张,并且分别位于一个高速互连域内。预填充大致对应处理输入,解码对应逐步生成输出;两组图既不能当成一台普通设备的结果,也不能把两个阶段的数字直接加在一起。
本文没有独立运行这套框架,因此不把作者发布的结果写成本站实测,更不据此承诺某个托管商的价格必然下降。真实服务中的请求长度、并发、缓存命中和等待时间,都会影响最终账单与体验。
项目还提供了离线评测说明,把生成和评分分开,并保留运行配置与原始输出。这里检查的是答案表现及部署是否符合预期,和单纯测吞吐量是两项工作。跑得快,并不足以证明部署没有引入质量问题。
例如,两组部署都报出某项答题分数,如果采用不同采样次数、评分器和提示模板,就未必可以直接比较。评测文档把生成结果保存下来,允许重新评分,正是为了让变化能被检查,而不是只留一个最终百分比。
DeepInfer 的直接受众,是研究推理系统、运行模型服务和建设内部部署的团队。普通用户更可能在后续产品中间接受益,而不会因为仓库出现,就自动获得更低的 API 价格。公开引擎让成本优化的方法可以被检查和迁移;能兑现多少收益,还要看它最终被接入怎样的服务。
评论